ノボジーン
  • ノボジーン
  • ゲノミクス
    • ヒト全ゲノムシーケンス
    • 動植物全ゲノムシーケンス
    • 微生物全ゲノムシーケンス
    • 動植物de novoシーケンス
    • 微生物de novoシーケンス
    • ショットガンメタゲノムシーケンス
    • アンプリコンシーケンス
    • 全エクソームシーケンス
    トランスクリプトミクス
    • mRNAシーケンス
    • トータルRNAシーケンス
    • 全長トランスクリプトームシーケンス
    • 全トランスクリプトームシーケンス
    • スモールRNAシーケンシング
    • 環状RNAシーケンス
    • メタトランスクリプトームシーケンス
    • 原核生物RNAシーケンス
    シングルセルと空間オミクス
    • シングルセル遺伝子発現解析
    • シングルセル免疫プロファイリングシーケンス
    • シングルセルロングリードトランスクリプトーム
    エピゲノミクス
    • 全ゲノムバイサルファイトシーケンス(WGBS)
    • ディレクトDNAメチレーションシーケンス(DM-Seq)new
    • 還元型バイサルファイトシーケンス (RRBS)
    • クロマチン免疫沈降シーケンス(ChIP-Seq)
    • RNA免疫沈降シーケンス (RIP-Seq)

    相乗りシーケンス

    • 相乗りシーケンス(イルミナプラットフォーム)
    • 相乗りシーケンス(PacBioプラットフォーム)
    プロテオミクス & メタボロミクス
    • Olinkプロテオミクス
  • プロモーションプロモーション
    • プラットフォーム
    • インテリジェント自動化プラットフォーム(Falcon)
    • バイオインフォマティクス解析ツール(NovoMagic)
    • カスタマサービスシステム(CSS)
    • パンフレット
    • ケーススタディ
    • ウェビナー
    • ブログ
    • サンプルガイドライン
    • コンミュニティ
    • がん研究
    • がん免疫
    • アグリゲノミクス
    • 環境
    • 食品科学
    • ヒトマイクロバイオーム
    • 植物および動物マイクロバイオーム
    • 創薬および開発
    • 希少および複雑性疾患
    • ノボジーンについて
    • 拠点一覧
    • ニュース
    • キャリア
  • お問い合わせお問い合わせ

サービスサービス menu

サポートサポート menu

会社会社 menu

サービス
全ゲノムシーケンスde novoシーケンスアンプリコンシーケンスショットガンメタゲノムシーケンスディレクトDNAメチレーションシーケンス(DM-Seq)mRNAシーケンスシングルセル遺伝子発現解析Olinkプロテオミクス
サポート
バイオインフォマティクス解析ツール(NovoMagic)カスタマサービスシステム(CSS)インテリジェント自動化プラットフォーム(Falcon)
会社
ノボジーンについて拠点一覧プラットフォームニュースキャリアお問い合わせ
YouTubeYouTube hoverXX hover
Copyright © 2026 Novogene Inc. All rights reserved. 本サービスは研究目的のみにご利用ください。臨床診断目的には使用頂けません。
banner laptop bg
banner mobile bg

全長トランスクリプトームシーケンス

全長転写産物を包括的にシーケンスし、転写産物構造、アイソフォームの多様性、遺伝子発現の複雑性を解明します。
ご相談ください
(全長トランスクリプトームシーケンス)
ご相談ください
(全長トランスクリプトームシーケンス)
概要概要
利点利点
アプリケーションアプリケーション
仕様仕様
リソースリソース

全長トランスクリプトームシーケンスは、完全で断片化されていないmRNA分子を捕えます。バイオインフォマティクスによる転写産物のアセンブリが不要となるため、新規遺伝子やアイソフォームに関するより包括的かつ正確な解析を実現します。ノボジーンは多様な研究目的に対応する各種全長トランスクリプトームソリューションを提供しています。


全長トランスクリプトームシーケンス(PacBio Iso-Seq): 選択的スプライシングイベント、融合遺伝子、変動発現アイソフォームを高精度で特徴付ける、費用対効果に優れた柔軟なソリューション。


ナノポアディレクトRNAシーケンス:cDNAへの変換なしに、mRNAを本来の形態のまま直接シーケンスし、塩基修飾(例:m6A、m5C)やポリA末端特性を研究します。

ノボジーンが全長トランスクリプトームシーケンスに選ばれる理由

エリア密着型サポート体制
エリア密着型サポート体制

各地域に配置されたテクニカルチームによる、個別対応かつ迅速なサービスを提供。

エリア密着型サポート体制
エリア密着型サポート体制

各地域に配置されたテクニカルチームによる、個別対応かつ迅速なサービスを提供。

包括的なカスタムソリューション
包括的なカスタムソリューション

複雑なサンプルや困難な研究課題に対応した、オーダーメイドのプロジェクト設計と解析。

包括的なカスタムソリューション
包括的なカスタムソリューション

複雑なサンプルや困難な研究課題に対応した、オーダーメイドのプロジェクト設計と解析。

豊富な経験
豊富な経験

300種を超える生物種、5,000超のサンプルから得たデータに裏付けられた、ノボジーンの全長トランスクリプトームシーケンスは実証済みの信頼性を提供します。

豊富な経験
豊富な経験

300種を超える生物種、5,000超のサンプルから得たデータに裏付けられた、ノボジーンの全長トランスクリプトームシーケンスは実証済みの信頼性を提供します。

保証されたデータ品質
保証されたデータ品質

ノボジーンのデータは、一貫してメーカーの性能ベンチマークを上回ります。

保証されたデータ品質
保証されたデータ品質

ノボジーンのデータは、一貫してメーカーの性能ベンチマークを上回ります。

研究・医療分野における全長トランスクリプトームシーケンスの応用

偏りのない完全なRNAプロファイルを解明し、生物医学、農業、生命科学研究における発見を促進します。

新規トランスクリプトと選択的スプライシング事象の発見

新規遺伝子、アイソフォーム、遺伝子融合を同定・評価します。選択的スプライシングを包括的にプロファイリングし、潜在的なバイオマーカーを明らかにします。

新規トランスクリプトと選択的スプライシング事象の発見

新規遺伝子、アイソフォーム、遺伝子融合を同定・評価します。選択的スプライシングを包括的にプロファイリングし、潜在的なバイオマーカーを明らかにします。

疾患メカニズムと薬剤耐性の解明

全長トランスクリプトと病態を関連付けることで疾患の分子基盤を調査。がんや感染症における薬剤耐性を駆動するトランスクリプトームレベルの変化を解明します。

疾患メカニズムと薬剤耐性の解明

全長トランスクリプトと病態を関連付けることで疾患の分子基盤を調査。がんや感染症における薬剤耐性を駆動するトランスクリプトームレベルの変化を解明します。

ゲノムアノテーションの強化

進化研究および機能研究をサポートする高品質なゲノムアノテーションを実現。

ゲノムアノテーションの強化

進化研究および機能研究をサポートする高品質なゲノムアノテーションを実現。

RNA修飾とポリ(A)動的プロファイリング(ディレクトRNAシーケンス)

転写後調節の研究に向け、主要なRNA修飾(例:m6A)の位置特定とポリAテール長測定を実施。

RNA修飾とポリ(A)動的プロファイリング(ディレクトRNAシーケンス)

転写後調節の研究に向け、主要なRNA修飾(例:m6A)の位置特定とポリAテール長測定を実施。

仕様

サンプル要件

サンプル量は参考値です。以下をダウンロードしてご確認ください。詳細については、サンプル要件をダウンロードしてご確認ください。カスタマイズされたご要望については、 お問い合わせください 。

サンプルタイプサービスサンプル量 (Qubit)濃度RIN (Agilent 2100)純度
(NanoDrop™)
TotaI RNAFull-Length Transcriptome Sequencing (PacBio)≥ 1.2 μg≥ 40 ng/μL≥ 6.5 with flat
baseline
OD260/280=1.8-2.2;
OD260/230=1.3-2.5;
*NC/QC ≤ 2.0;
No genomic contamination
TotaI RNANanopore Direct RNA Sequencing≥ 5.5 μg≧ 375 ng/μL≥ 7 (animals, plants, fungi);
≥ 8 (Human)
OD260/280=1.8-2.2;
OD260/230=1.6-2.5;
*NC/QC ≤ 2;
No genomic contamination
Note:
*NC/QC: NanoDrop concentration/Qubit concentration

シーケンスおよび解析

表示されている推奨データ量および解析内容は参考値です。カスタマイズされたご要望については、 お問い合わせください 。

プラットフォームFull-Length Transcriptome Sequencing (PacBio)Direct RNA (Nanopore)
Read LengthN50 read length (average) ≥ 1.5 kbN50 read length (average) ≥ 1 kb
Recommended Data Amount• 5 million HiFi reads for highly expressed genes/isoforms detection
• 10 million HiFi reads for moderate/rare genes/isoforms detection
10M~20M reads/sample
(1 PromethION cell/ sample)
Data Analysis Capability• Data QC
• Function Annotation

With reference genome
• Structure analysis
• Alternative splicing
• Alternative polyadenylation
• Novel gene/ Novel transcript prediction and annotation
• Transcription factor analysis
• LncRNA prediction
• Fusion transcript analysis

Without reference genome
• Structure analysis
• Prediction of coding sequences
• Transcription factor analysis
• SSR analysis
• LncRNA prediction

Quantification analysis is available without the aid of short-read mRNA-seq when choosing 10M HiFi reads.
• Gene/ Transcript expression level analysis
• Differentially expressed gene/ transcript analysis
(Transcript analysis can only be conducted when a reference genome is available.)
• Full-length transcripts identification and classification
• Transcript structure analysis
-Alternative splicing
-Novel gene/ Novel transcript prediction and annotation
-Transcription factor analysis
-LncRNA prediction
• Quantification analysis
• Differential gene expression analysis
• GO/KEGG enrichment analysis of differentially expressed genes
• RNA modification analysis
• Poly(A) analysis

*This service is limited to species with a reference genome.

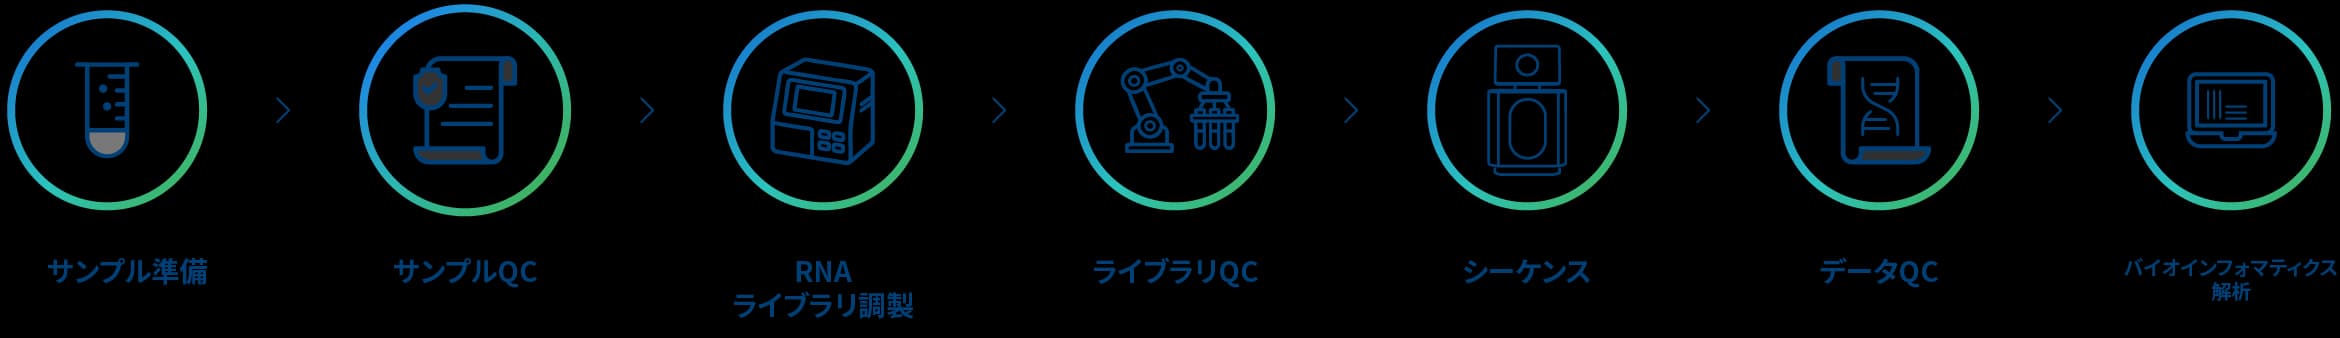
プロジェクトワークフロー

ノボジーンの全長トランスクリプトームシーケンスのワークフローは、厳密な段階的プロセスにより高品質な結果を提供します。

プロジェクトワークフロー

解析例

Image
Image
1/1
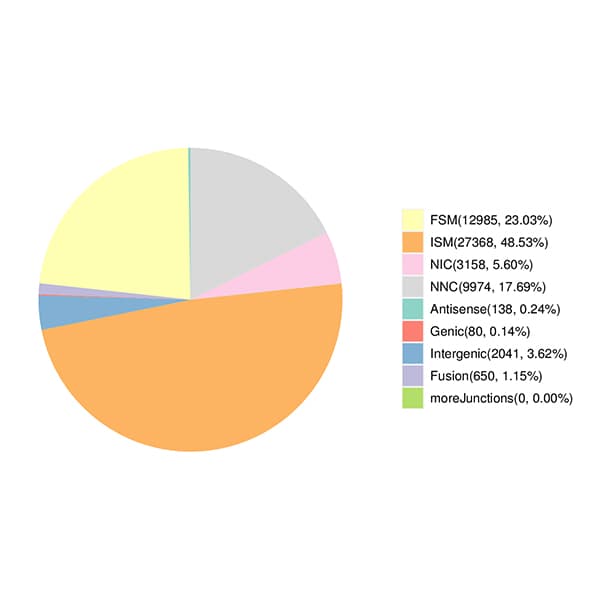
全長転写産物の分類

円グラフは全長転写産物の分類を示します。

Image
Image
1/1
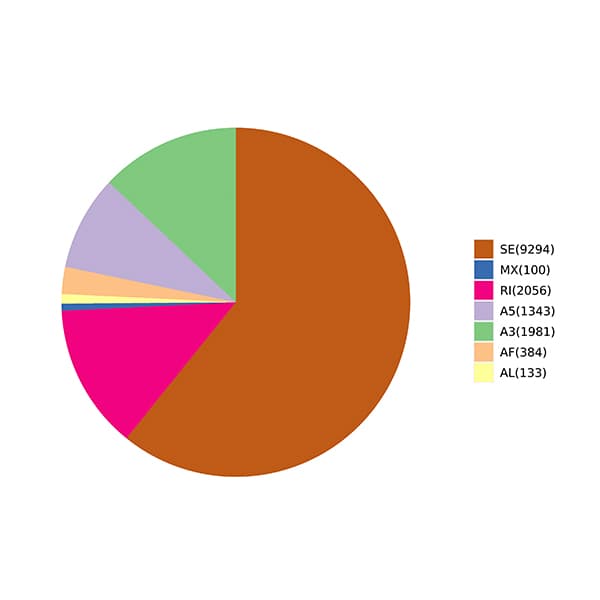
選択的スプライシング

全長転写産物シーケンスデータから得られた選択的スプライシングイベントの概要

Image
Image
1/1
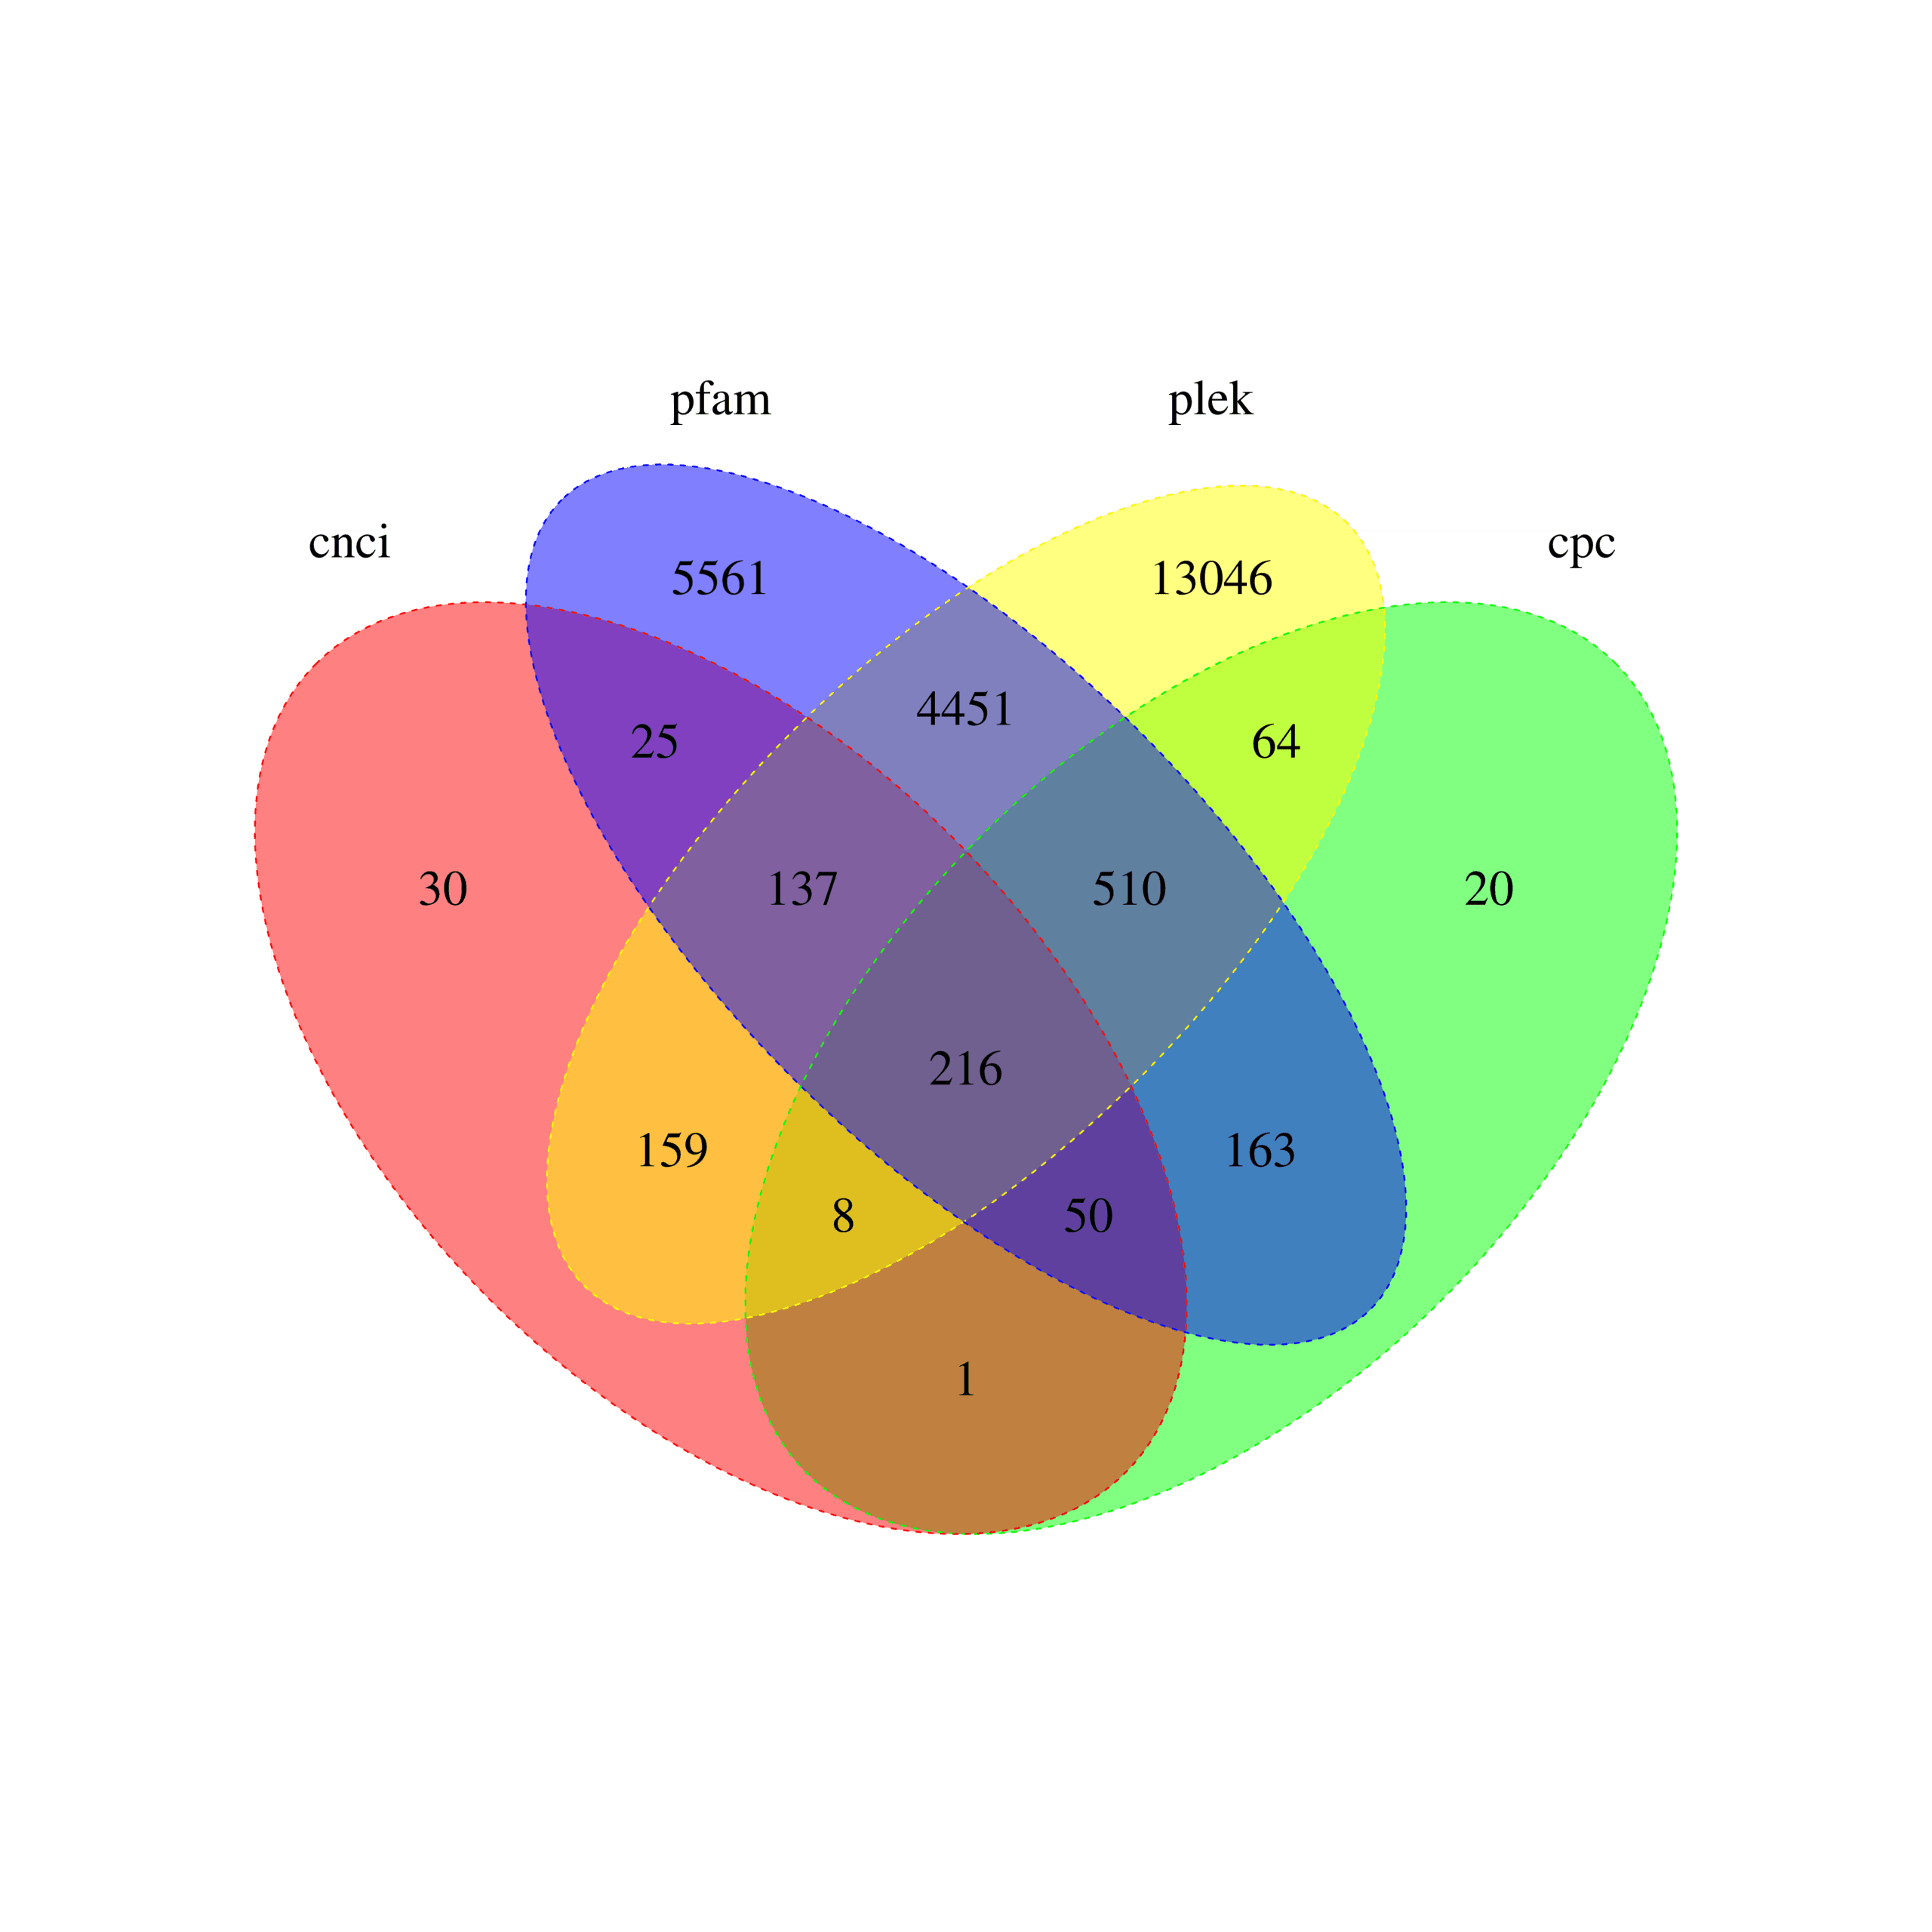
lncRNA予測および解析

ベン図は複数ツールによるノンコーディング転写産物予測を比較し、信頼性の高い下流解析のために選択されたコンセンサスセットを示します。

Image
Image
1/1
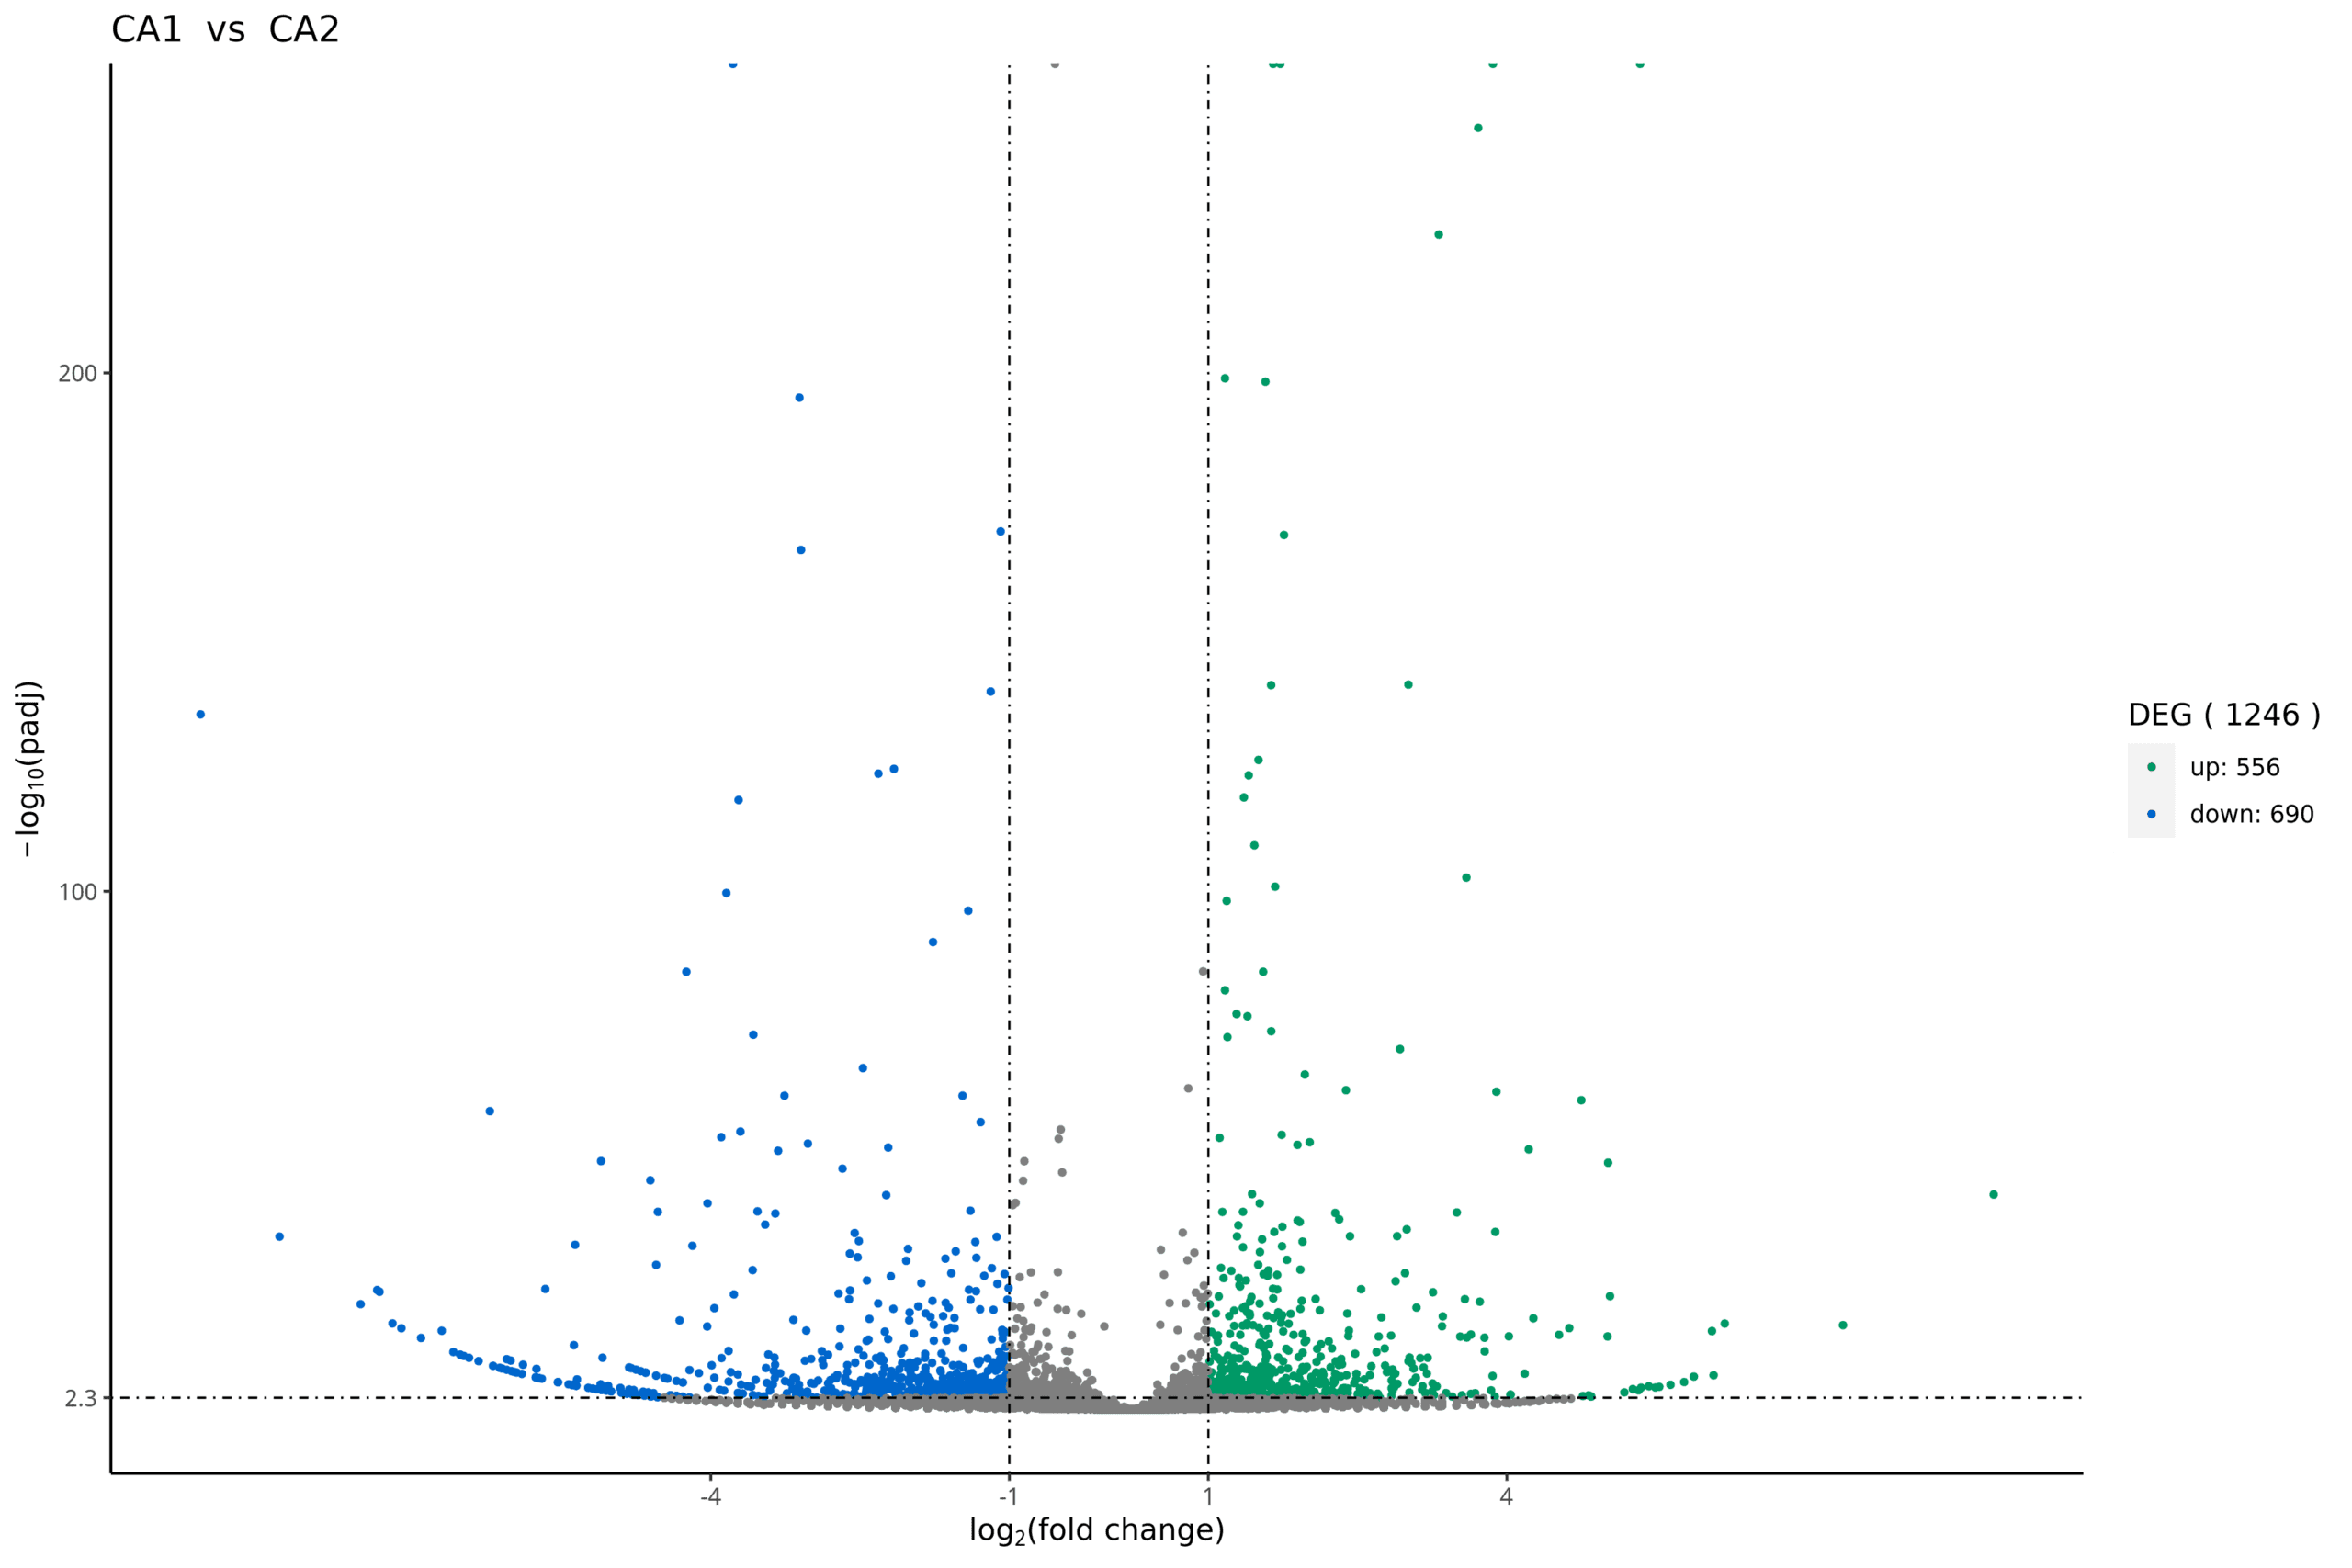
変動遺伝子発現解析

ボルケーノプロットは変動発現解析の結果を要約し、発現変化が有意な遺伝子を直ちに示します。

Image
Image
1/1
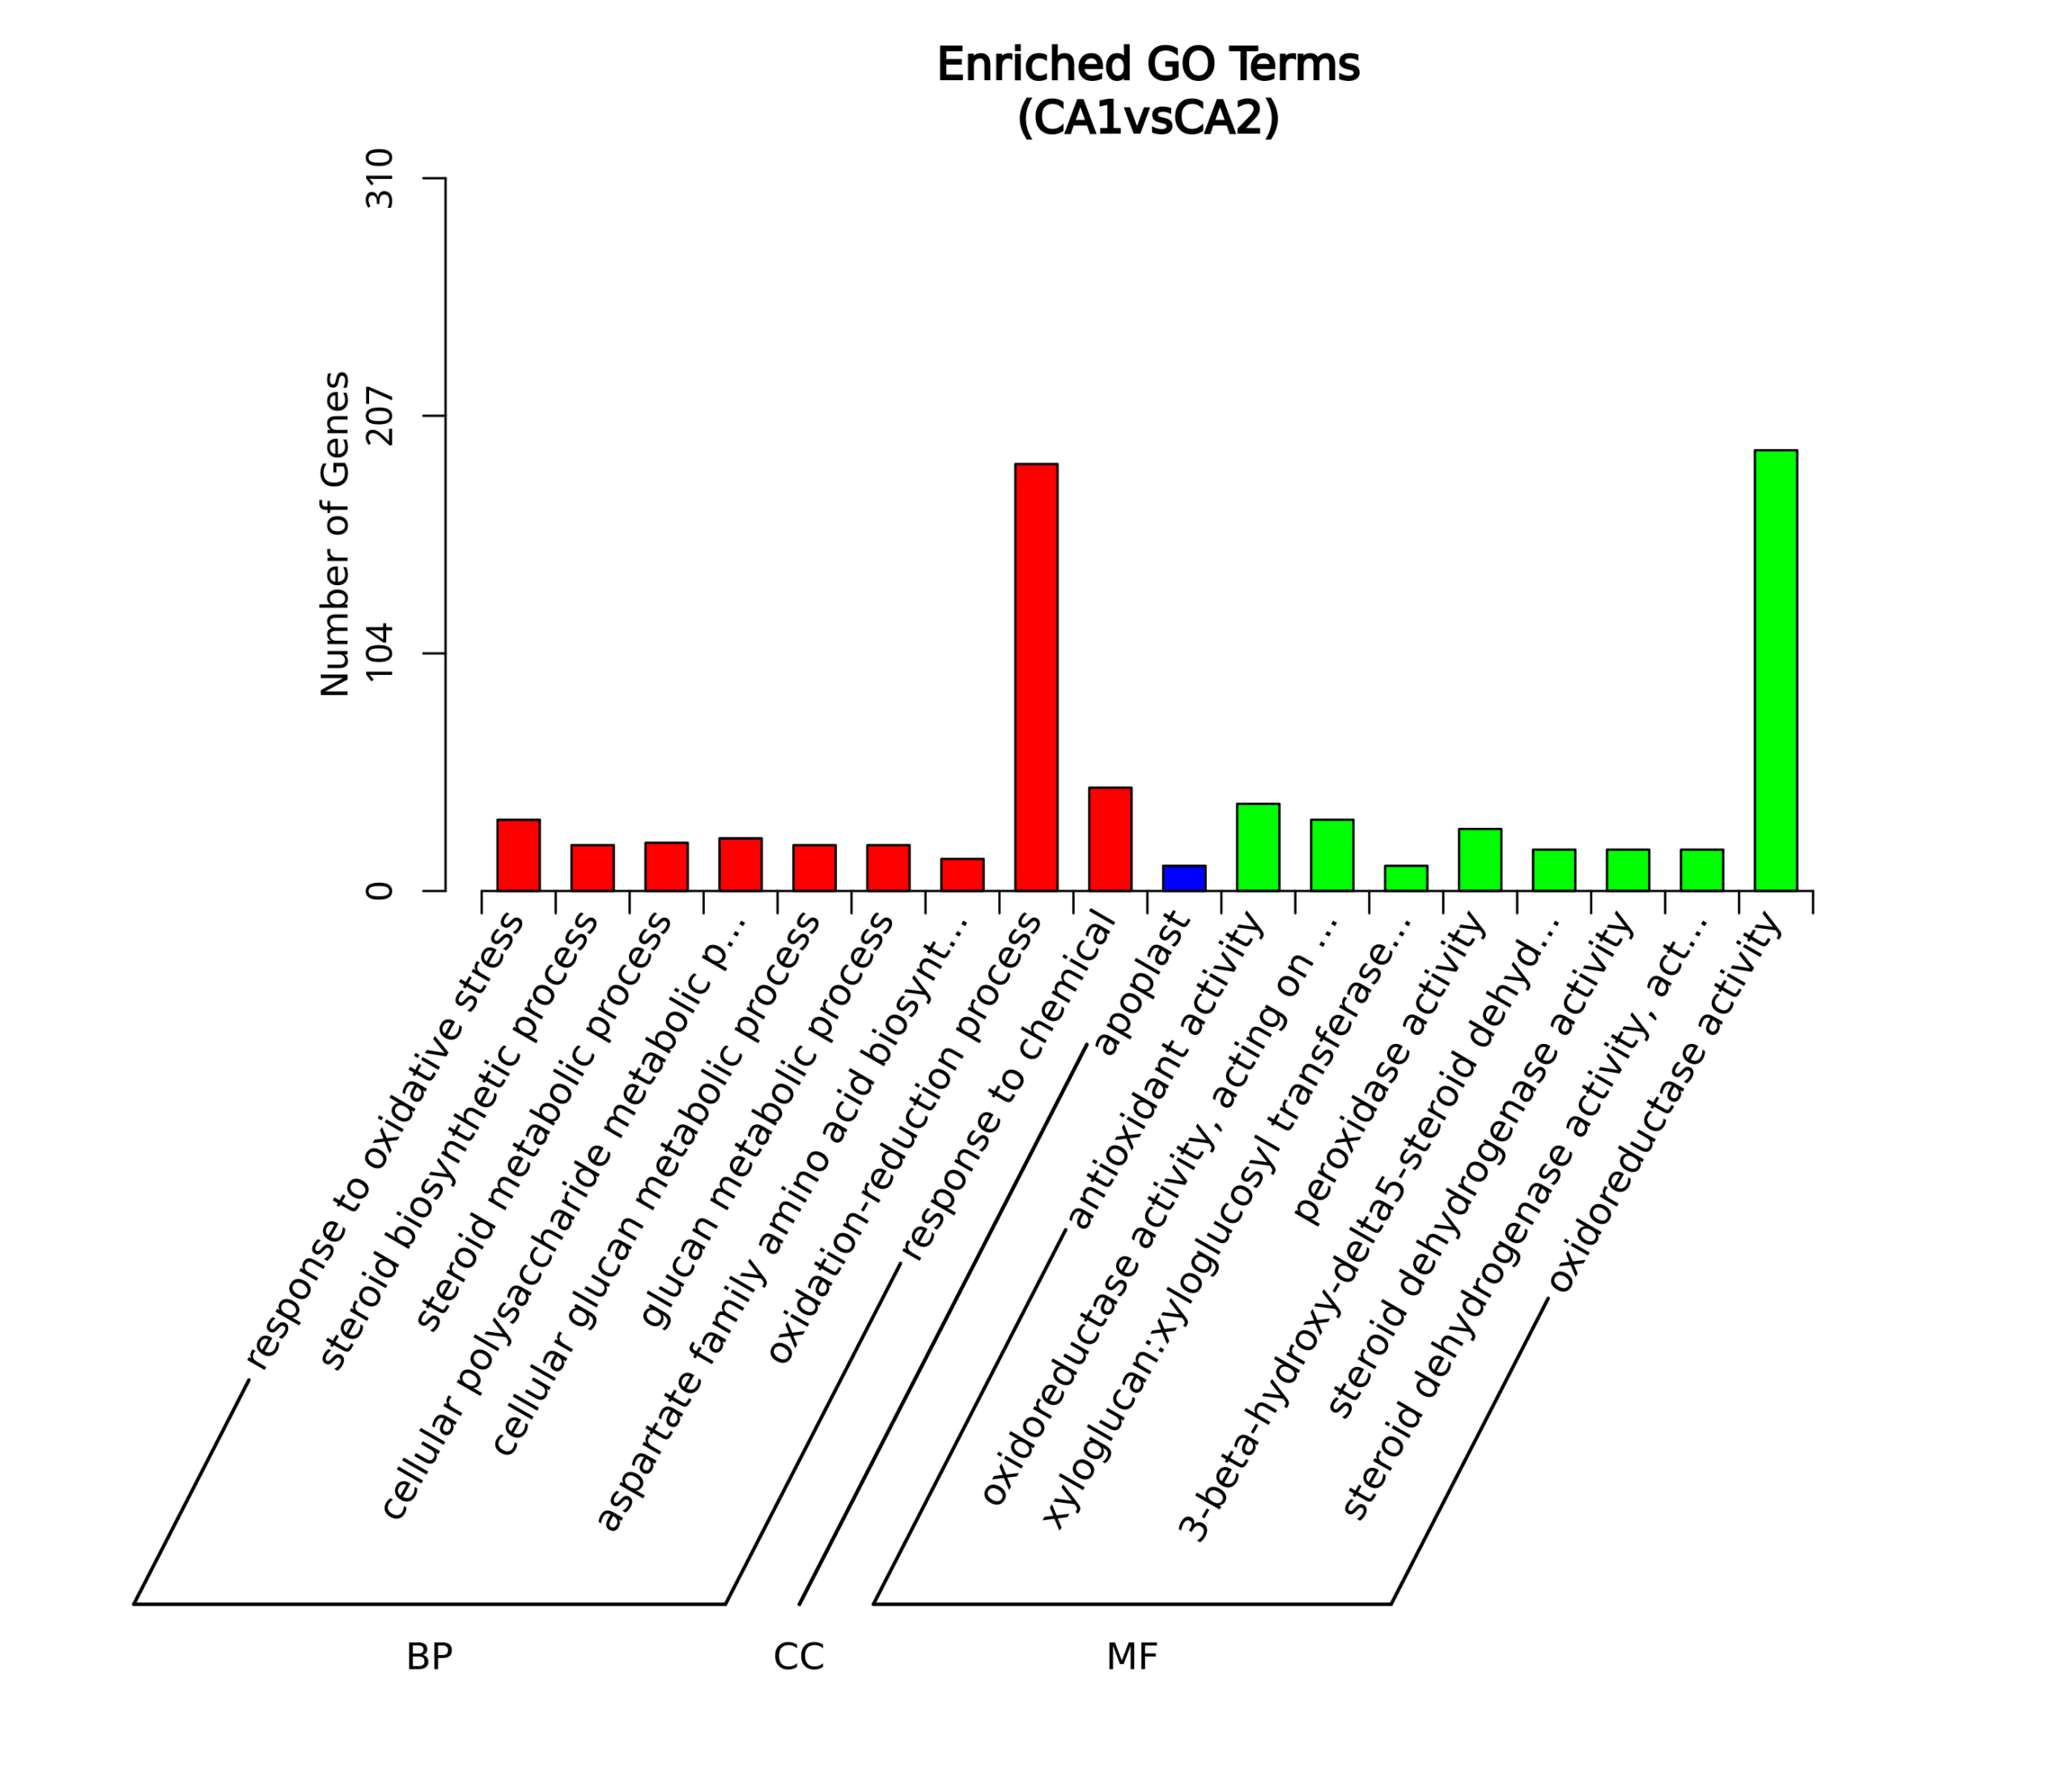
変動発現遺伝子のエンリッチメント解析

棒グラフは、変動発現遺伝子の機能エンリッチメント解析から得られた、最も有意に濃縮されたGene Ontologyタームを表示します。

Image
Image
1/1
全長転写産物の分類

円グラフは全長転写産物の分類を示します。

Image
Image
1/1
選択的スプライシング

全長転写産物シーケンスデータから得られた選択的スプライシングイベントの概要

Image
Image
1/1
lncRNA予測および解析

ベン図は複数ツールによるノンコーディング転写産物予測を比較し、信頼性の高い下流解析のために選択されたコンセンサスセットを示します。

Image
Image
1/1
変動遺伝子発現解析

ボルケーノプロットは変動発現解析の結果を要約し、発現変化が有意な遺伝子を直ちに示します。

Image
Image
1/1
変動発現遺伝子のエンリッチメント解析

棒グラフは、変動発現遺伝子の機能エンリッチメント解析から得られた、最も有意に濃縮されたGene Ontologyタームを表示します。

その他のサービス

RNAシーケンス(RNA-seq)
(RNAシーケンス(RNA-seq))
RNAシーケンス(RNA-seq)
(RNAシーケンス(RNA-seq))
トータルRNAシーケンス
(トータルRNAシーケンス)
トータルRNAシーケンス
(トータルRNAシーケンス)
全トランスクリプトームシーケンス
(全トランスクリプトームシーケンス)
全トランスクリプトームシーケンス
(全トランスクリプトームシーケンス)

その他のサービス

RNAシーケンス(RNA-seq)
(RNAシーケンス(RNA-seq))
RNAシーケンス(RNA-seq)
(RNAシーケンス(RNA-seq))
トータルRNAシーケンス
(トータルRNAシーケンス)
トータルRNAシーケンス
(トータルRNAシーケンス)
全トランスクリプトームシーケンス
(全トランスクリプトームシーケンス)
全トランスクリプトームシーケンス
(全トランスクリプトームシーケンス)
Background
Background

プロジェクトを開始する準備はできていますか?

ノボジーンのプラットフォームは、

プロジェクト設計からデータ納品まで、お客様固有の実験ニーズに合わせたソリューションを提供し、シームレスな体験を実現します。


プライバシーポリシーCookieポリシーキャリア