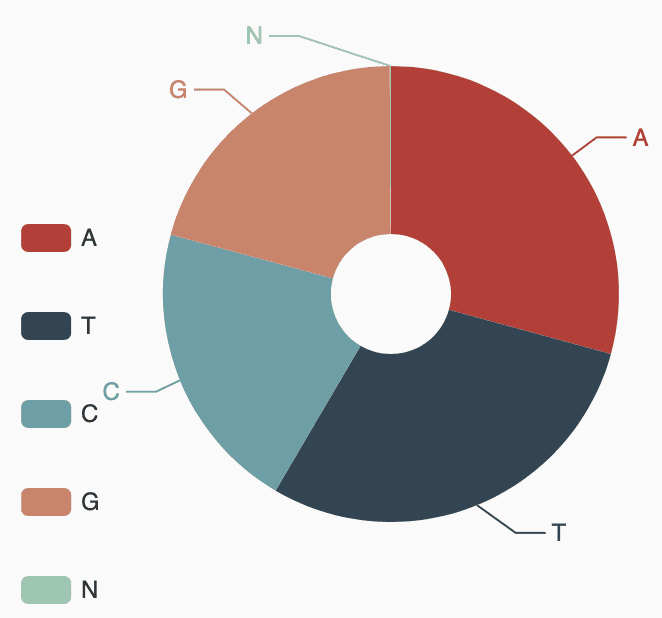
ノボジーン
  • ノボジーン
  • ゲノミクス
    • ヒト全ゲノムシーケンス
    • 動植物全ゲノムシーケンス
    • 微生物全ゲノムシーケンス
    • 動植物de novoシーケンス
    • 微生物de novoシーケンス
    • ショットガンメタゲノムシーケンス
    • アンプリコンシーケンス
    • 全エクソームシーケンス
    トランスクリプトミクス
    • mRNAシーケンス
    • トータルRNAシーケンス
    • 全長トランスクリプトームシーケンス
    • 全トランスクリプトームシーケンス
    • スモールRNAシーケンシング
    • 環状RNAシーケンス
    • メタトランスクリプトームシーケンス
    • 原核生物RNAシーケンス
    シングルセルと空間オミクス
    • シングルセル遺伝子発現解析
    • シングルセル免疫プロファイリングシーケンス
    • シングルセルロングリードトランスクリプトーム
    エピゲノミクス
    • 全ゲノムバイサルファイトシーケンス(WGBS)
    • ディレクトDNAメチレーションシーケンス(DM-Seq)new
    • 還元型バイサルファイトシーケンス (RRBS)
    • クロマチン免疫沈降シーケンス(ChIP-Seq)
    • RNA免疫沈降シーケンス (RIP-Seq)

    相乗りシーケンス

    • 相乗りシーケンス(イルミナプラットフォーム)
    • 相乗りシーケンス(PacBioプラットフォーム)
    プロテオミクス & メタボロミクス
    • Olinkプロテオミクス
  • プロモーションプロモーション
    • プラットフォーム
    • インテリジェント自動化プラットフォーム(Falcon)
    • バイオインフォマティクス解析ツール(NovoMagic)
    • カスタマサービスシステム(CSS)
    • パンフレット
    • ケーススタディ
    • ウェビナー
    • ブログ
    • サンプルガイドライン
    • コンミュニティ
    • がん研究
    • がん免疫
    • アグリゲノミクス
    • 環境
    • 食品科学
    • ヒトマイクロバイオーム
    • 植物および動物マイクロバイオーム
    • 創薬および開発
    • 希少および複雑性疾患
    • ノボジーンについて
    • 拠点一覧
    • ニュース
    • キャリア
  • お問い合わせお問い合わせ

サービスサービス menu

サポートサポート menu

会社会社 menu

サービス
全ゲノムシーケンスde novoシーケンスアンプリコンシーケンスショットガンメタゲノムシーケンスディレクトDNAメチレーションシーケンス(DM-Seq)mRNAシーケンスシングルセル遺伝子発現解析Olinkプロテオミクス
サポート
バイオインフォマティクス解析ツール(NovoMagic)カスタマサービスシステム(CSS)インテリジェント自動化プラットフォーム(Falcon)
会社
ノボジーンについて拠点一覧プラットフォームニュースキャリアお問い合わせ
YouTubeYouTube hoverXX hover
Copyright © 2026 Novogene Inc. All rights reserved. 本サービスは研究目的のみにご利用ください。臨床診断目的には使用頂けません。
banner laptop bg
banner mobile bg

植物・動物de novoシーケンス

複雑なゲノムおよび種固有のゲノム特性を正確に解明するため、植物・動物ゲノムのde novoアセンブリを行います。
ご相談ください
(植物・動物de novoシーケンス)
ご相談ください
(植物・動物de novoシーケンス)
概要概要
利点利点
アプリケーションアプリケーション
仕様仕様
リソースリソース

de novoシーケンスとは、参照ゲノムに依存せずに生物種のゲノムをシーケンス・アセンブルし、その種の完全なゲノム配列マップを構築する手法です。このアプローチにより包括的なゲノム配列マップが得られるだけでなく、その種の進化的起源や特定環境への適応をさらに研究するための基盤が築かれます。

実験操作およびバイオインフォマティクス解析における豊富な経験を基に、ノボジーンは生物種を正確、迅速かつ包括的に解析し、信頼性の高い結果を提供します。また、ノボジーンのエンドツーエンドサービスにより、非常に迅速なターンアラウンドを実現します。

ノボジーンの植物・動物de novoシーケンスサービスの利点

豊富な実績
豊富な実績

多様な植物・動物種について、参照品質ゲノムのアセンブリを実現してきた実績

豊富な実績
豊富な実績

多様な植物・動物種について、参照品質ゲノムのアセンブリを実現してきた実績

高品質データ
高品質データ

業界標準の性能とアセンブリに適したコンティグN50を備えた高品質シーケンスデータを提供

高品質データ
高品質データ

業界標準の性能とアセンブリに適したコンティグN50を備えた高品質シーケンスデータを提供

ショートリードとロングリードの統合
ショートリードとロングリードの統合

ロングリードとショートリードのデータを組み合わせ、包括的なゲノムアセンブリを実現する柔軟なde novoシーケンス戦略

ショートリードとロングリードの統合
ショートリードとロングリードの統合

ロングリードとショートリードのデータを組み合わせ、包括的なゲノムアセンブリを実現する柔軟なde novoシーケンス戦略

高度なバイオインフォマティクスサポート
高度なバイオインフォマティクスサポート

ロングリードデータを用いたエンドツーエンドのアセンブリソリューション、T2TゲノムおよびHi-C統合による染色体レベルアセンブリにも対応

高度なバイオインフォマティクスサポート
高度なバイオインフォマティクスサポート

ロングリードデータを用いたエンドツーエンドのアセンブリソリューション、T2TゲノムおよびHi-C統合による染色体レベルアセンブリにも対応

カスタマーサービスシステム(CSS)
カスタマーサービスシステム(CSS)

プロジェクトの進捗管理、データアクセス、シーケンスワークフロー全体におけるシームレスな共同作業を実現する一元管理プラットフォーム

カスタマーサービスシステム(CSS)
カスタマーサービスシステム(CSS)

プロジェクトの進捗管理、データアクセス、シーケンスワークフロー全体におけるシームレスな共同作業を実現する一元管理プラットフォーム

植物・動物de novoシーケンスのアプリケーション

生物多様性の保護と進化研究(動物)

環境適応の遺伝的基盤を明らかにし、進化の歴史をたどるとともに、絶滅危惧種の保護に重要な知見を提供します。

生物多様性の保護と進化研究(動物)

環境適応の遺伝的基盤を明らかにし、進化の歴史をたどるとともに、絶滅危惧種の保護に重要な知見を提供します。

農業と家畜の育種

疾病抵抗性、生産性、望ましい形質に関連する遺伝子を同定し、より健康で高収量な系統の開発を可能にします。

農業と家畜の育種

疾病抵抗性、生産性、望ましい形質に関連する遺伝子を同定し、より健康で高収量な系統の開発を可能にします。

生物医学研究と創薬

より優れた動物疾患モデル(例:ゼブラフィッシュ)の作製を促進するとともに、がん抵抗性などの特性を持つ動物に固有の生物学的パスウェイを明らかにし、創薬研究をサポートします。

生物医学研究と創薬

より優れた動物疾患モデル(例:ゼブラフィッシュ)の作製を促進するとともに、がん抵抗性などの特性を持つ動物に固有の生物学的パスウェイを明らかにし、創薬研究をサポートします。

作物改良と食料安全(植物)

高収量、高栄養価、ストレス耐性を備えた作物品種の育種を可能にする完全な遺伝的設計図を提供し、世界の食料安全に貢献します。

作物改良と食料安全(植物)

高収量、高栄養価、ストレス耐性を備えた作物品種の育種を可能にする完全な遺伝的設計図を提供し、世界の食料安全に貢献します。

進化と適応研究(植物)

進化の歴史を明らかにし、環境ストレスに対する植物の適応を支える遺伝的機構を解明します。

進化と適応研究(植物)

進化の歴史を明らかにし、環境ストレスに対する植物の適応を支える遺伝的機構を解明します。

遺伝資源の探索

有用化合物や画期的な農業形質に関わる新規遺伝子の発見を先導し、農業およびバイオテクノロジー全体のイノベーションを推進します。

遺伝資源の探索

有用化合物や画期的な農業形質に関わる新規遺伝子の発見を先導し、農業およびバイオテクノロジー全体のイノベーションを推進します。

仕様

サンプル要件

記載されているサンプル量はあくまで目安です。詳細については、サンプル要件 をダウンロードしてご確認ください。具体的なご要望や詳細につきましては、お問い合わせください。

プラットフォームタイプサンプルタイプサンプル量 (Qubit®)純度
Illumina NovaSeq SystemGenomic DNA≥ 200 ngOD260/280=1.8-2.0;
no degradation,
no contamination
PacBio Revio SystemHMW Genomic DNA≥ 3.5 μgOD260/280=1.75~2.0;
OD260/230=1.5~2.6;
*NC/QC=1.00~2.20;
Fragments should be ≥30K
Nanopore PromethIONHMW Genomic DNA≥ 8.5 μgOD260/280=1.75~2.0;
OD260/230=1.4~2.6;
*NC/QC=0.95~3.00
Fragments should be ≥30K
Nanopore PromethION
(Nanopore Ultra-long DNA Library)
uHMW Genomic DNA≥ 20 μgOD260/280=1.7-2.0;
OD260/230=1.3-2.6;
*NC/QC=0.95-3.00;
Fragments should be ≥ 100k, no fragments below 30k.
*NC/QC = NanoDrop concentration/Qubit concentration

シーケンスおよび解析

表示されている推奨データ出力および分析内容は、あくまで参考情報です。詳細につきましては、 お問い合わせください。 ご要望に合わせて個別にご案内いたしますので、

シーケンスタイプイルミナNovaSeq
プラットフォーム
PacBio Revio
プラットフォーム
Nanopore PromethION
プラットフォーム
Read LengthPaired-end 150 bpN50>15 kbAverage > 50 kb
Recommended  Sequencing DepthFor genome survey or assembly polishing: ≥ 50×
RNA requires 4 to 6 different tissue sites.
For genome assembly: ≥ 30×
Standard AnalysisK-mer analysis
GC content analysis
Repeat content rate evaluation
Heterozygous rate evaluation
Genome size evaluation
Long-read assembly
Assembly statistics
Gene completeness evaluation
Genome Annotation-Repeat prediction
Structure prediction
Function prediction
Noncoding RNA prediction

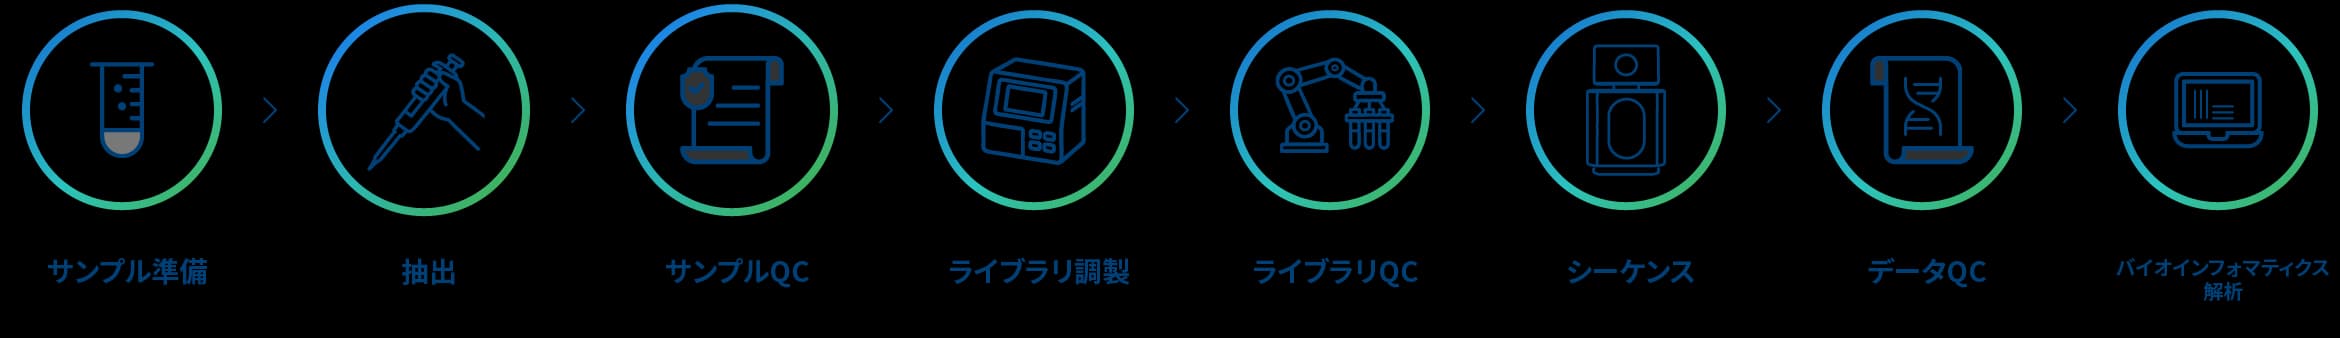
プロジェクトワークフロー

プロジェクトワークフロー

解析例

Image
Image
1/1
アセンブリ統計

アブラムシゲノムのA/T/G/C含量統計を取得

Image
Image
1/1
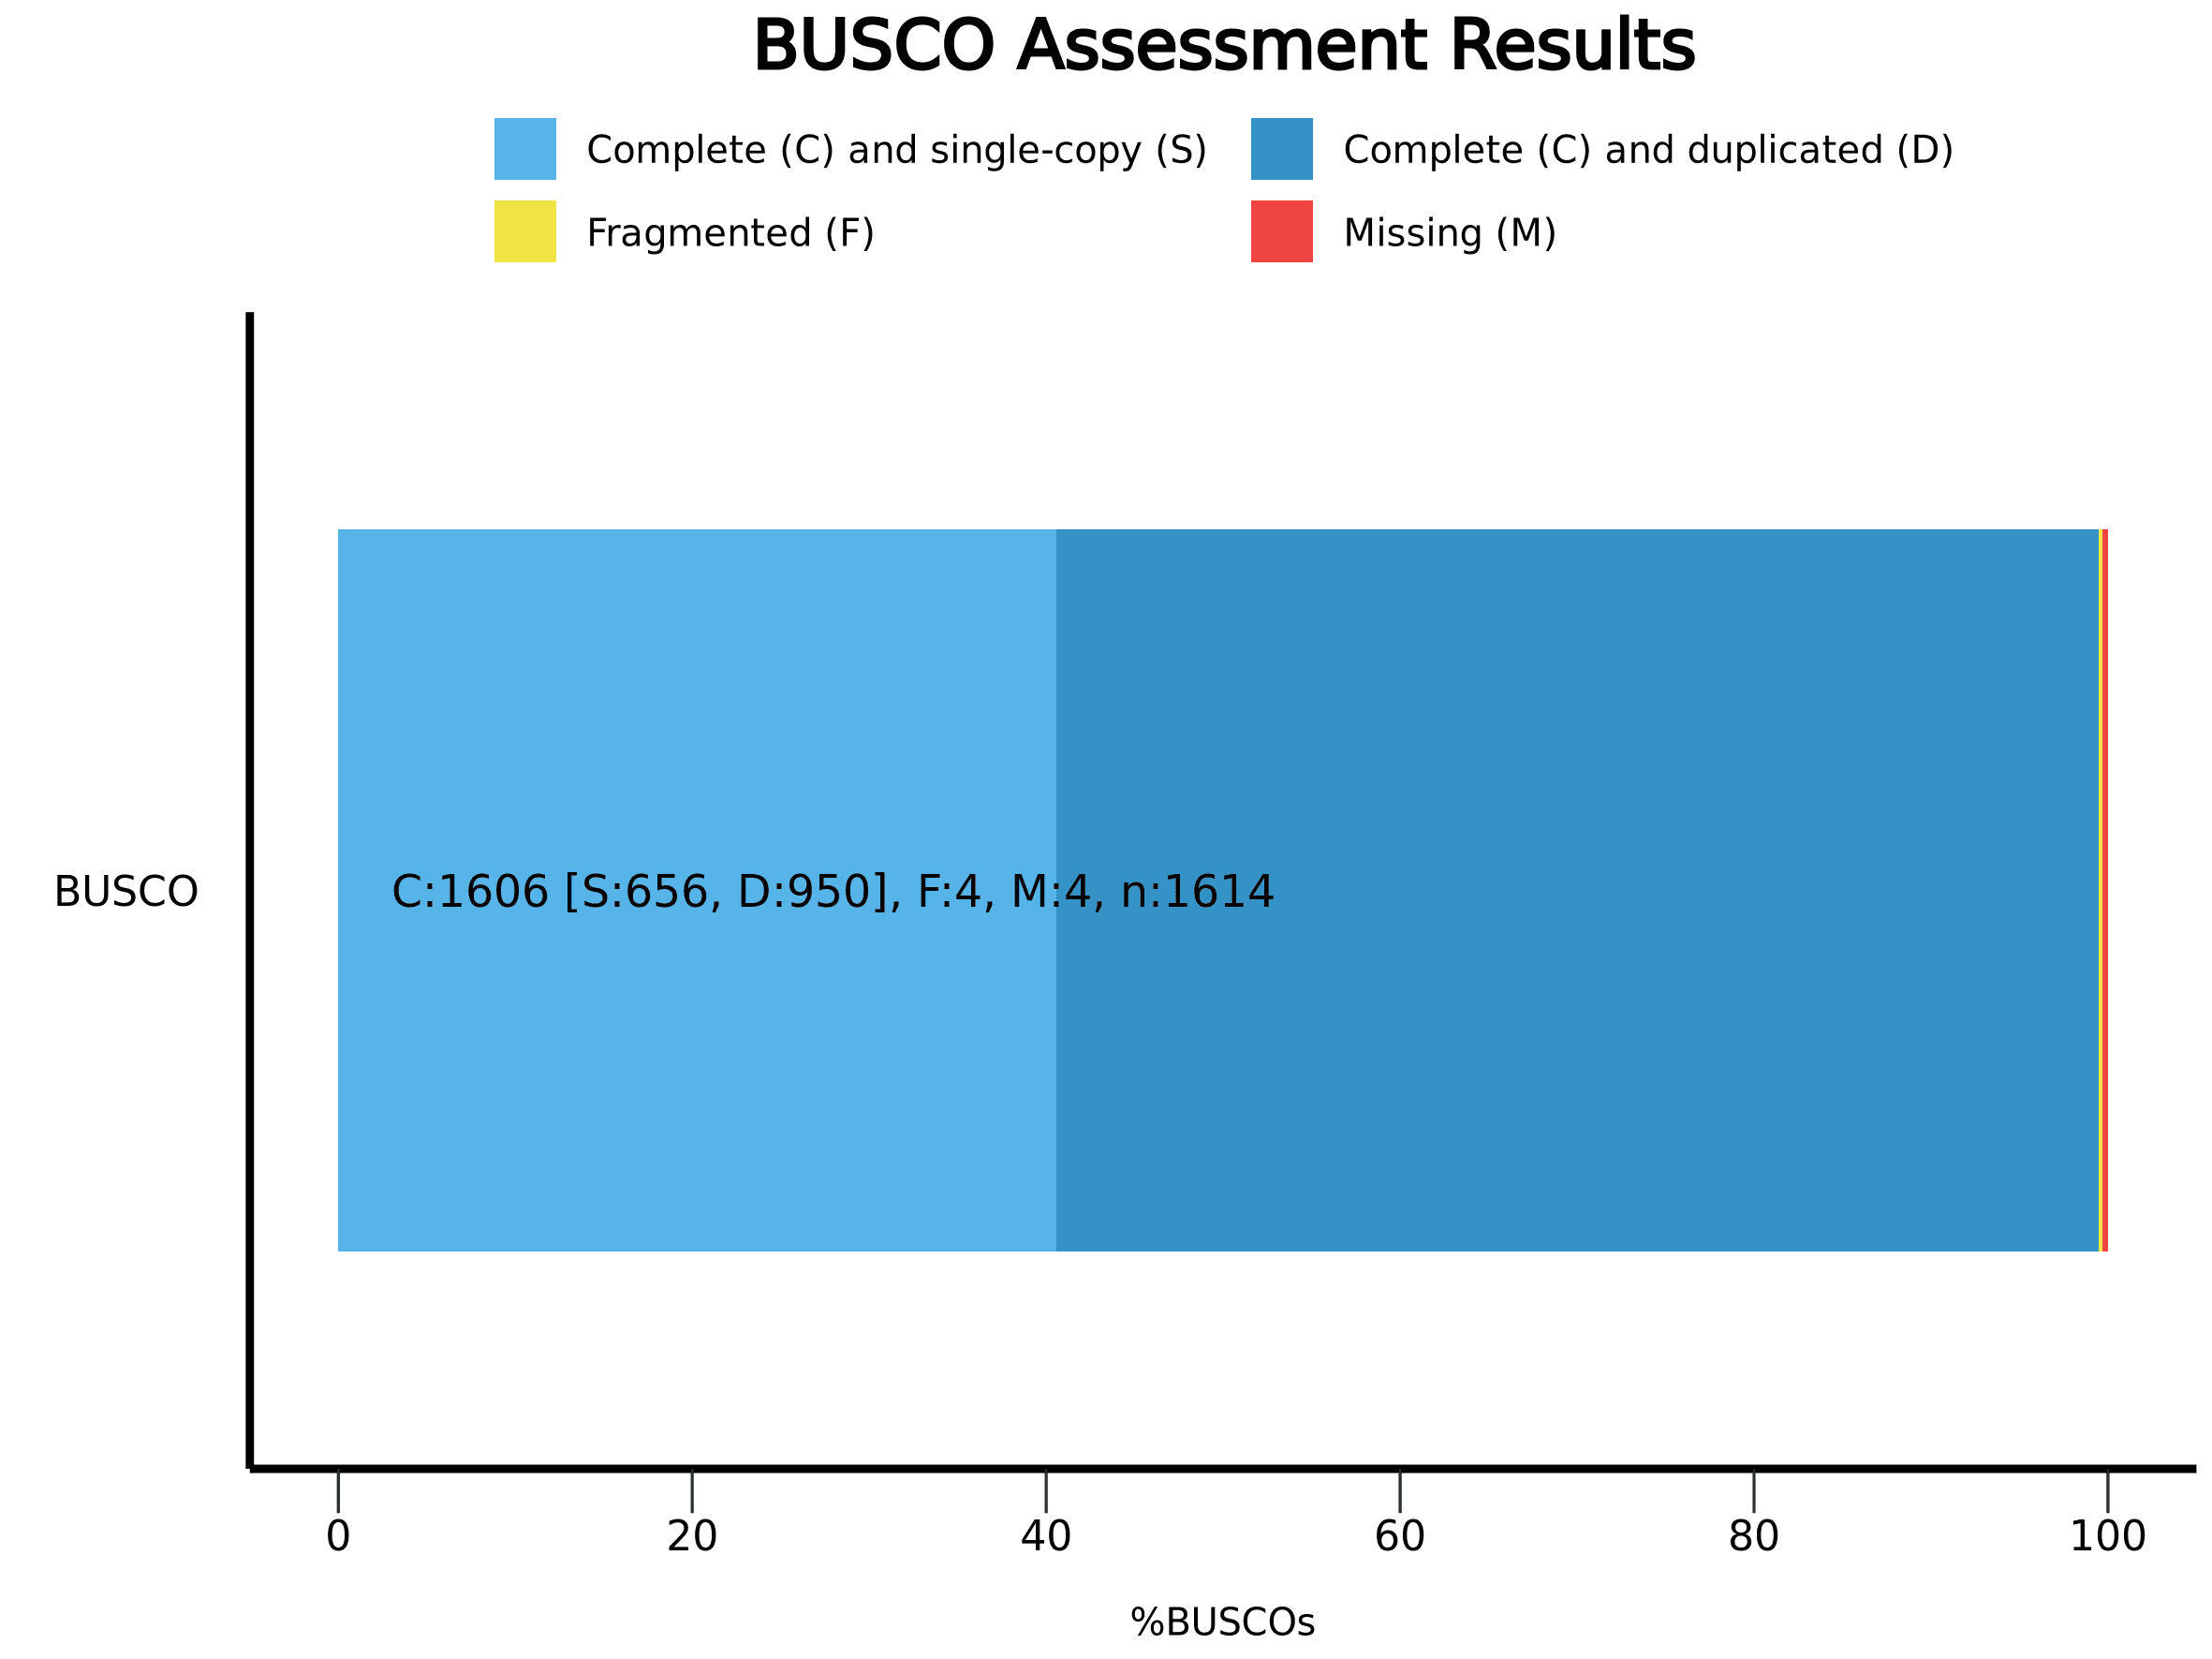
アセンブリ評価 - BUSCO評価

BUSCO評価結果

注:C:完全なBUSCO、S:完全かつシングルコピーのBUSCO、D:完全な重複BUSCO、F:断片化BUSCO、M:欠失BUSCO、n:検索したBUSCOグループ総数。

Image
Image
1/1
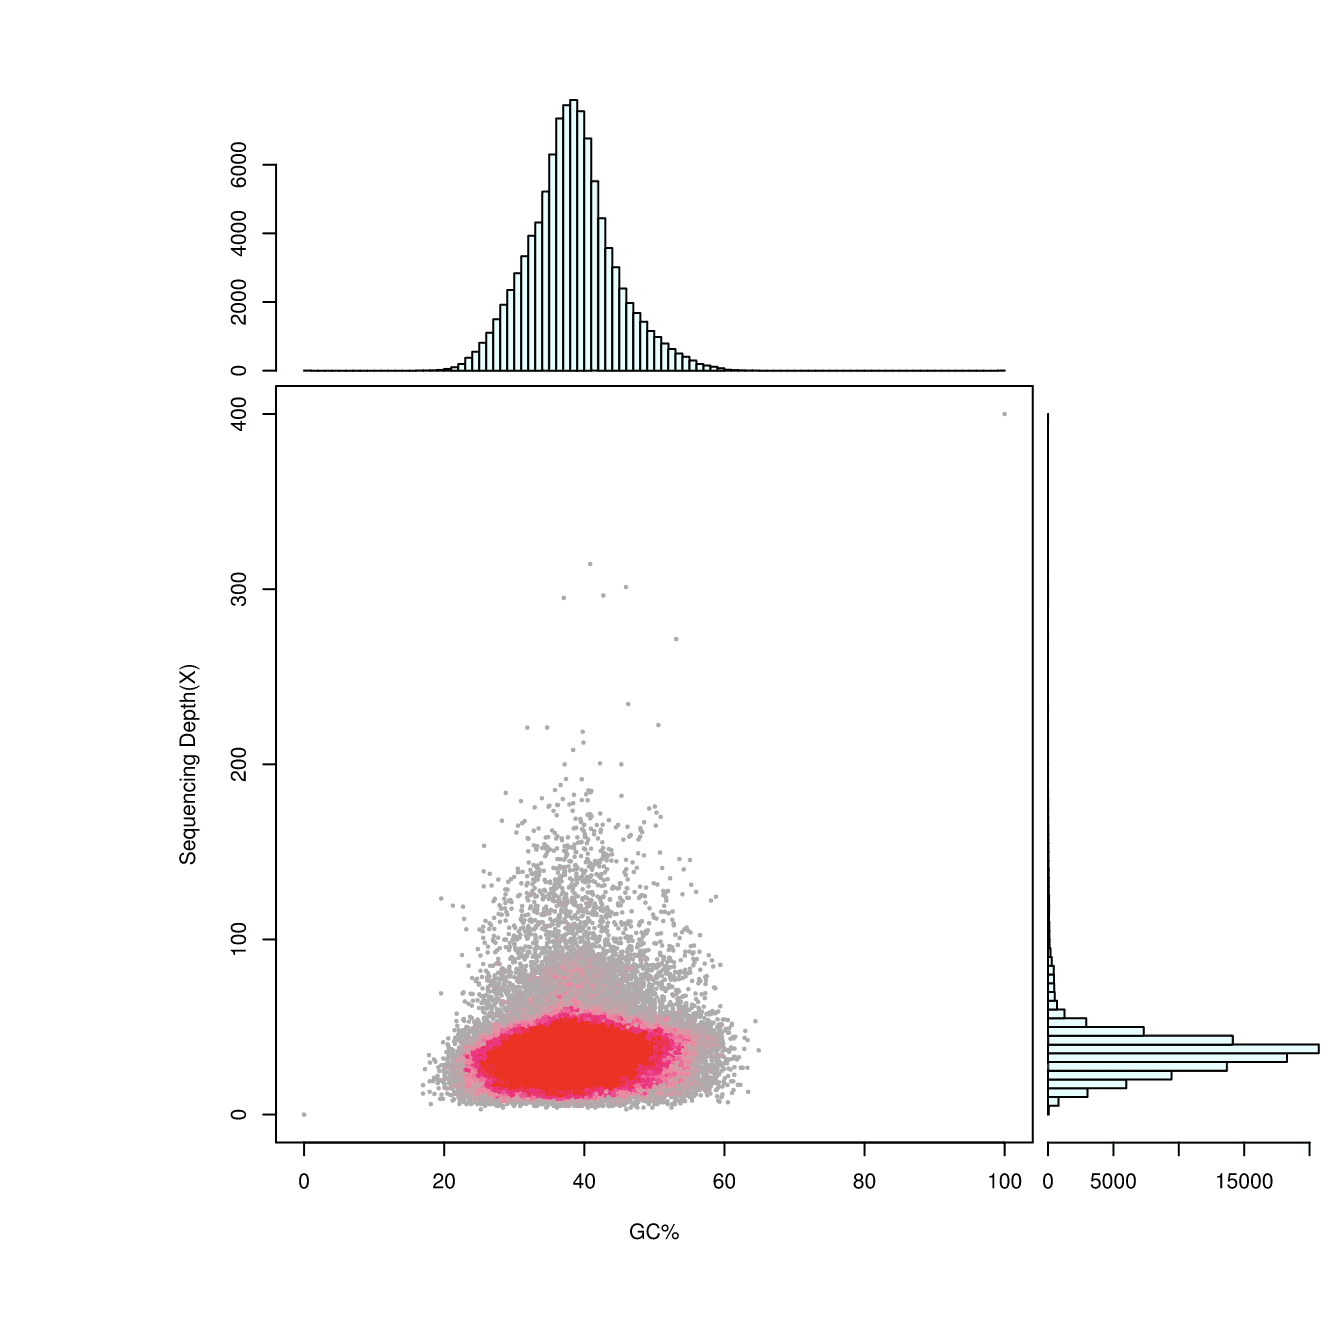
GC含量とデプスの分布

横軸:GC含量、縦軸:シーケンスデプス

上:GC含量の分布

右下:シーケンスデプスの分布

Image
Image
1/1
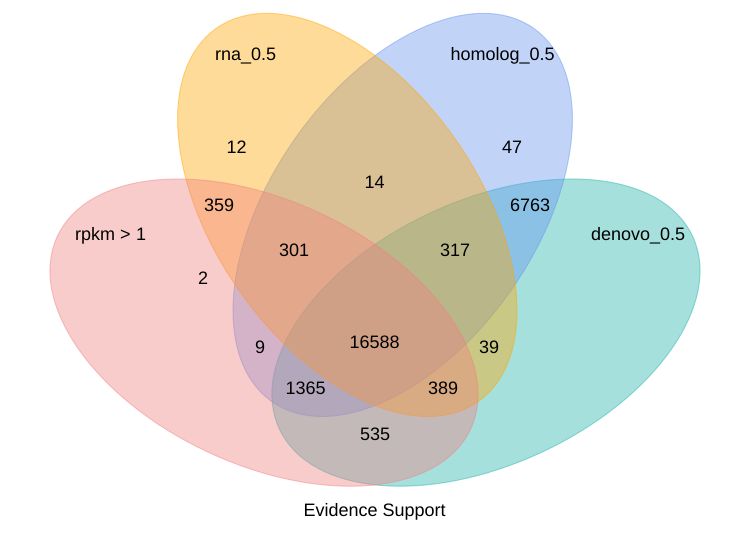
エビデンスサポート

遺伝子セットのエビデンスサポートに関するベン図de novo遺伝子構造予測には、Augustus、GlimmerHMM、SNAP、Geneid、Genscanを使用します。

Image
Image
1/1
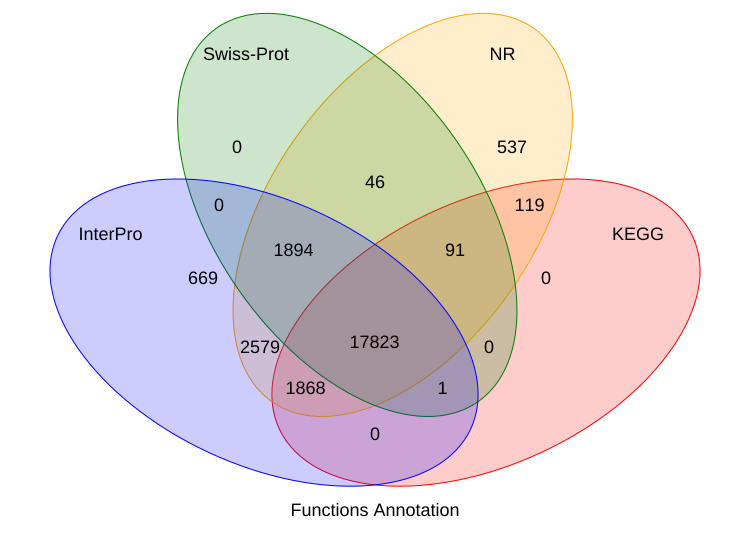
機能予測

遺伝子機能アノテーションのベン図。遺伝子構造から予測されたタンパク質配列を既知タンパク質データベースとアラインメントします。結果から、遺伝子の95.8%で機能予測が可能であることが示されました。

Image
Image
1/1
アセンブリ統計

アブラムシゲノムのA/T/G/C含量統計を取得

Image
Image
1/1
アセンブリ評価 - BUSCO評価

BUSCO評価結果

注:C:完全なBUSCO、S:完全かつシングルコピーのBUSCO、D:完全な重複BUSCO、F:断片化BUSCO、M:欠失BUSCO、n:検索したBUSCOグループ総数。

Image
Image
1/1
GC含量とデプスの分布

横軸:GC含量、縦軸:シーケンスデプス

上:GC含量の分布

右下:シーケンスデプスの分布

Image
Image
1/1
エビデンスサポート

遺伝子セットのエビデンスサポートに関するベン図de novo遺伝子構造予測には、Augustus、GlimmerHMM、SNAP、Geneid、Genscanを使用します。

Image
Image
1/1
機能予測

遺伝子機能アノテーションのベン図。遺伝子構造から予測されたタンパク質配列を既知タンパク質データベースとアラインメントします。結果から、遺伝子の95.8%で機能予測が可能であることが示されました。

K-mer解析

K-mer=17解析およびゲノムサイズ評価

SampleKmerDepthn_kmerGenome_size(M)Genome_size(M)Genome_size(M)Repeat_rate(%)
plant173624,079,467,724668.87668.87668.8773
(1) K-mer: Selected K-mer length.
(2) Depth:The expected value of K-mer depth.
(3) n_K-mer:The total number of K-mer from SOAPdenovo.
(4) Genome size(M):The genome size in Mb estimated by formula: Genome Size=K-mer_num/Peak_depth.
(5) Revise Genome size(M):Revised genome size after error correction from wrong K-mer.
(6) Heteozygous ratio:The percent of heteozygous positions.
(7) Repeat:Calculated by the percentage of K-mer numbers after 1.8-fold of the main peak of total K-mer numbers.
Note: The repeat here is a mathematically repeated sequence but not a repeat element with certain biological functions.

よくあるご質問

アセンブリ結果の信頼性を確保するには?アセンブリの完全性と精度を評価する主な方法は何ですか?

Contig N50およびScaffold N50の指標を確認することに加え、アセンブリの品質評価も不可欠です。一般的な評価方法には、BUSCO、LAI、Merqury、CEGMA、EST配列評価、RNA配列評価、コンセンサス評価があります。BUSCOはシングルコピーオルソログ遺伝子のライブラリを用いてゲノムを評価し、LAIは長末端反復配列レトロトランスポゾンに基づいてゲノム完全性を評価します。MerquryはゲノムのQV(Quality Value)を評価します。現在、これら3つは最も広く用いられている評価手法です。

de novoアセンブリに推奨される仕様は何ですか?

サーベイとゲノムde novoでは同じDNAが必要ですか?

その他のサービス

トータルRNAシーケンス
(トータルRNAシーケンス)
トータルRNAシーケンス
(トータルRNAシーケンス)
完全長トランスクリプトームシーケンス
(完全長トランスクリプトームシーケンス)
完全長トランスクリプトームシーケンス
(完全長トランスクリプトームシーケンス)
植物・動物全ゲノムシーケンス
(植物・動物全ゲノムシーケンス)
植物・動物全ゲノムシーケンス
(植物・動物全ゲノムシーケンス)

その他のサービス

トータルRNAシーケンス
(トータルRNAシーケンス)
トータルRNAシーケンス
(トータルRNAシーケンス)
完全長トランスクリプトームシーケンス
(完全長トランスクリプトームシーケンス)
完全長トランスクリプトームシーケンス
(完全長トランスクリプトームシーケンス)
植物・動物全ゲノムシーケンス
(植物・動物全ゲノムシーケンス)
植物・動物全ゲノムシーケンス
(植物・動物全ゲノムシーケンス)
Background
Background

プロジェクトを開始する準備はできていますか?

ノボジーンのプラットフォームは、

お客様固有の実験ニーズに合わせたソリューションを提供し、プロジェクトの設計からデータの納品に至るまで、スムーズなプロセスをお約束します。


プライバシーポリシーCookieポリシーキャリア