ノボジーン
  • ノボジーン
  • ゲノミクス
    • ヒト全ゲノムシーケンス
    • 動植物全ゲノムシーケンス
    • 微生物全ゲノムシーケンス
    • 動植物de novoシーケンス
    • 微生物de novoシーケンス
    • ショットガンメタゲノムシーケンス
    • アンプリコンシーケンス
    • 全エクソームシーケンス
    トランスクリプトミクス
    • mRNAシーケンス
    • トータルRNAシーケンス
    • 全長トランスクリプトームシーケンス
    • 全トランスクリプトームシーケンス
    • スモールRNAシーケンシング
    • 環状RNAシーケンス
    • メタトランスクリプトームシーケンス
    • 原核生物RNAシーケンス
    シングルセルと空間オミクス
    • シングルセル遺伝子発現解析
    • シングルセル免疫プロファイリングシーケンス
    • シングルセルロングリードトランスクリプトーム
    エピゲノミクス
    • 全ゲノムバイサルファイトシーケンス(WGBS)
    • ディレクトDNAメチレーションシーケンス(DM-Seq)new
    • 還元型バイサルファイトシーケンス (RRBS)
    • クロマチン免疫沈降シーケンス(ChIP-Seq)
    • RNA免疫沈降シーケンス (RIP-Seq)

    相乗りシーケンス

    • 相乗りシーケンス(イルミナプラットフォーム)
    • 相乗りシーケンス(PacBioプラットフォーム)
    プロテオミクス & メタボロミクス
    • Olinkプロテオミクス
  • プロモーションプロモーション
    • プラットフォーム
    • インテリジェント自動化プラットフォーム(Falcon)
    • バイオインフォマティクス解析ツール(NovoMagic)
    • カスタマサービスシステム(CSS)
    • パンフレット
    • ケーススタディ
    • ウェビナー
    • ブログ
    • サンプルガイドライン
    • コンミュニティ
    • がん研究
    • がん免疫
    • アグリゲノミクス
    • 環境
    • 食品科学
    • ヒトマイクロバイオーム
    • 植物および動物マイクロバイオーム
    • 創薬および開発
    • 希少および複雑性疾患
    • ノボジーンについて
    • 拠点一覧
    • ニュース
    • キャリア
  • お問い合わせお問い合わせ

サービスサービス menu

サポートサポート menu

会社会社 menu

サービス
全ゲノムシーケンスde novoシーケンスアンプリコンシーケンスショットガンメタゲノムシーケンスディレクトDNAメチレーションシーケンス(DM-Seq)mRNAシーケンスシングルセル遺伝子発現解析Olinkプロテオミクス
サポート
バイオインフォマティクス解析ツール(NovoMagic)カスタマサービスシステム(CSS)インテリジェント自動化プラットフォーム(Falcon)
会社
ノボジーンについて拠点一覧プラットフォームニュースキャリアお問い合わせ
YouTubeYouTube hoverXX hover
Copyright © 2026 Novogene Inc. All rights reserved. 本サービスは研究目的のみにご利用ください。臨床診断目的には使用頂けません。
banner laptop bg
banner mobile bg

RNA免疫沈降シーケンス(RIP-seq)

RNA-タンパク質相互作用をトランスクリプトームワイドに解析し、転写後制御およびRNA制御機構を明らかにします。
ご相談ください
(RNA免疫沈降シーケンス(RIP-seq))
ご相談ください
(RNA免疫沈降シーケンス(RIP-seq))
概要概要
利点利点
アプリケーションアプリケーション
仕様仕様
リソースリソース

RNA免疫沈降シーケンス(RIP-seq、RIPシーケンス)は、タンパク質-RNA相互作用を体系的に解析するためのハイスループットRNAシーケンステクノロジーです。ターゲットタンパク質とRNA分子の結合イベントをゲノムワイドに特性評価し、それにより遺伝子発現、RNAスプライシング、RNA安定性、細胞内局在、翻訳制御などの重要な生物学的プロセスにおけるRNA結合タンパク質(RBP)の制御機構を解明します。


本テクノロジーでは、mRNAやノンコーディングRNA(ncRNA)を含む多様なRNA種を1回の実験で同時に検出できます。ChIP-seqやATAC-seqなどの相補的なテクノロジーと組み合わせることで、RIP-seqは生物学的活動の分子基盤を包括的かつ詳細に理解するためのマルチオミクス解析を可能にします。

RIP-seqプロジェクトでノボジーンが選ばれる理由

迅速かつ高い処理能力
迅速かつ高い処理能力

業界をリードする納期

迅速かつ高い処理能力
迅速かつ高い処理能力

業界をリードする納期

微量に対応
微量に対応

超微量の断片化RNA(20 ng)に対応


微量に対応
微量に対応

超微量の断片化RNA(20 ng)に対応


包括的な解析
包括的な解析

RIP-seqは、lncRNAやmiRNAなどのncRNAに関するRNA-RBP相互作用ネットワークを多面的に解析できます。

包括的な解析
包括的な解析

RIP-seqは、lncRNAやmiRNAなどのncRNAに関するRNA-RBP相互作用ネットワークを多面的に解析できます。

RNA免疫沈降シーケンス(RIP-seq)のアプリケーション

RIP-seqはRNA生物学および遺伝子制御の分野で広く利用されています。主なアプリケーションは以下のとおりです。

RNA結合タンパク質のRNAターゲットの同定

RIP-seqにより、特定のRBPに結合するRNAをマッピングし、その制御ターゲットを同定できます。ターゲットにはmRNAやノンコーディングRNA(ncRNA)が含まれる場合があります。

RNA結合タンパク質のRNAターゲットの同定

RIP-seqにより、特定のRBPに結合するRNAをマッピングし、その制御ターゲットを同定できます。ターゲットにはmRNAやノンコーディングRNA(ncRNA)が含まれる場合があります。

発生および疾患におけるRNA-タンパク質相互作用の理解

RIP-seqは、胚発生、細胞分化、がんなどの疾患において、RBPがRNAプロセシングをどのように制御するかを調べるために用いることができます。

発生および疾患におけるRNA-タンパク質相互作用の理解

RIP-seqは、胚発生、細胞分化、がんなどの疾患において、RBPがRNAプロセシングをどのように制御するかを調べるために用いることができます。

ncRNAの機能解析

RIP-seqは、特定のRBPに結合するノンコーディングRNA(ncRNA)を研究するために利用でき、その制御機能に関する知見を提供します。

ncRNAの機能解析

RIP-seqは、特定のRBPに結合するノンコーディングRNA(ncRNA)を研究するために利用でき、その制御機能に関する知見を提供します。

仕様

サンプル要件

サンプル量は参考値です。詳細については、サンプル要件 をダウンロードしてご確認ください。カスタマイズされたご要望については、お問い合わせください。

サンプルタイプサンプル量ピーク分布純度
Enriched RNA Sample≥ 100 ng
(Concentration ≥ 3 ng/μL)
For unfragmented sample,
fragment should be ≥ 1000 bp.
A260/280>2.0

サンプル要件

サンプル量は参考値です。詳細については、サンプル要件 をダウンロードしてご確認ください。カスタマイズされたご要望については、お問い合わせください。

サンプルタイプサンプル量ピーク分布純度
Enriched RNA Sample≥ 100 ng
(Concentration ≥ 3 ng/μL)
For unfragmented sample,
fragment should be ≥ 1000 bp.
A260/280>2.0

サンプル要件

サンプル量は参考値です。詳細については、サンプル要件 をダウンロードしてご確認ください。カスタマイズされたご要望については、お問い合わせください。

サンプルタイプサンプル量ピーク分布純度
Enriched RNA Sample≥ 100 ng
(Concentration ≥ 3 ng/μL)
For unfragmented sample,
fragment should be ≥ 1000 bp.
A260/280>2.0

サンプル要件

サンプル量は参考値です。詳細については、サンプル要件 をダウンロードしてご確認ください。カスタマイズされたご要望については、お問い合わせください。

サンプルタイプサンプル量ピーク分布純度
Enriched RNA Sample≥ 100 ng
(Concentration ≥ 3 ng/μL)
For unfragmented sample,
fragment should be ≥ 1000 bp.
A260/280>2.0

シーケンスおよび解析

表示されている推奨データ量および解析内容は参考値です。カスタマイズされたご要望については、 お問い合わせください。

シーケンスプラットフォームIllumina NovaSeq System
Read LengthPaired-end 150bp
Recommended Data Amount≥ 20 million read pairs per sample for the species with a reference genome
Content of Data AnalysisData quality control
Alignment to the reference genome
Peak calling
Motif Analysis
Peak annotation
Functional analysis of peak-associated genes
Visualization of RIP-seq data

プロジェクトワークフロー

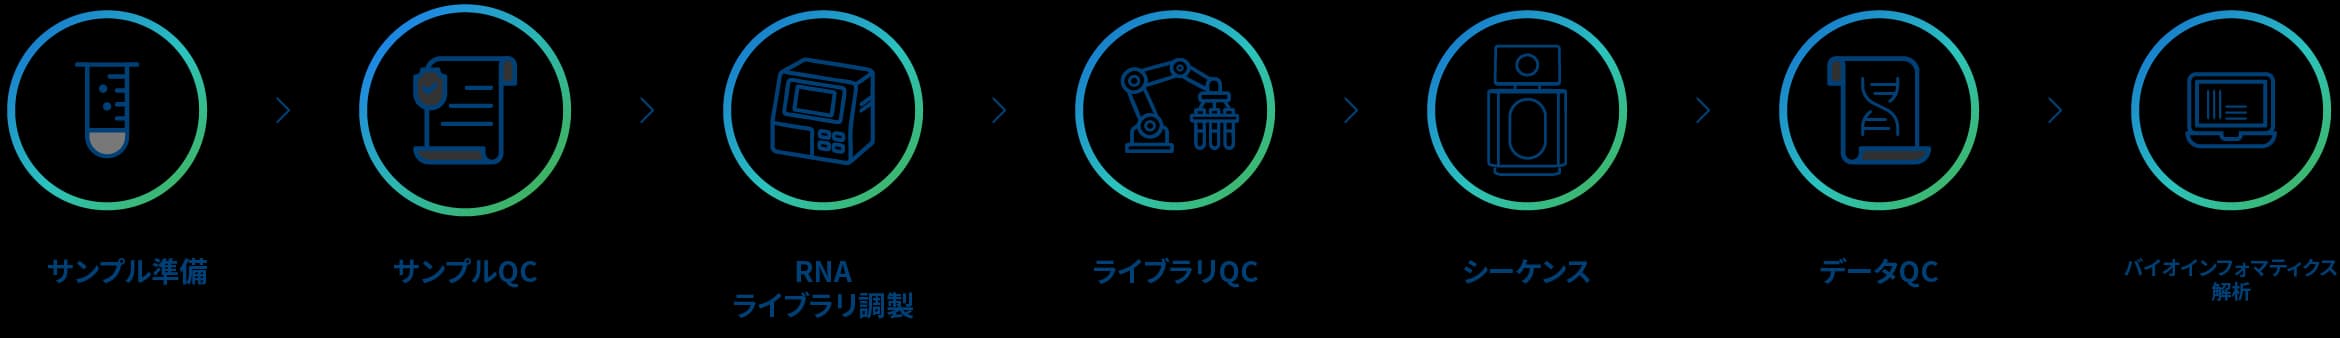
ノボジーンのRIP-seqサービスは、サンプル調製、RNAライブラリ調製、Illumina PE150シーケンス、バイオインフォマティクスパイプラインによるデータ解析の4段階で構成されています。RNAサンプリングからデータレポートの取得に至るまで、各工程はデータ出力量と品質に影響し、その後のバイオインフォマティクス解析結果にも直接影響します。ノボジーンでは、サンプルQC、ライブラリQC、シーケンスデータQCを含むすべての工程を厳格に検証し、高品質・高精度・高信頼性のシーケンスデータと包括的なバイオインフォマティクス解析を提供します。


プロジェクトワークフロー

解析例

Image
Image
1/1
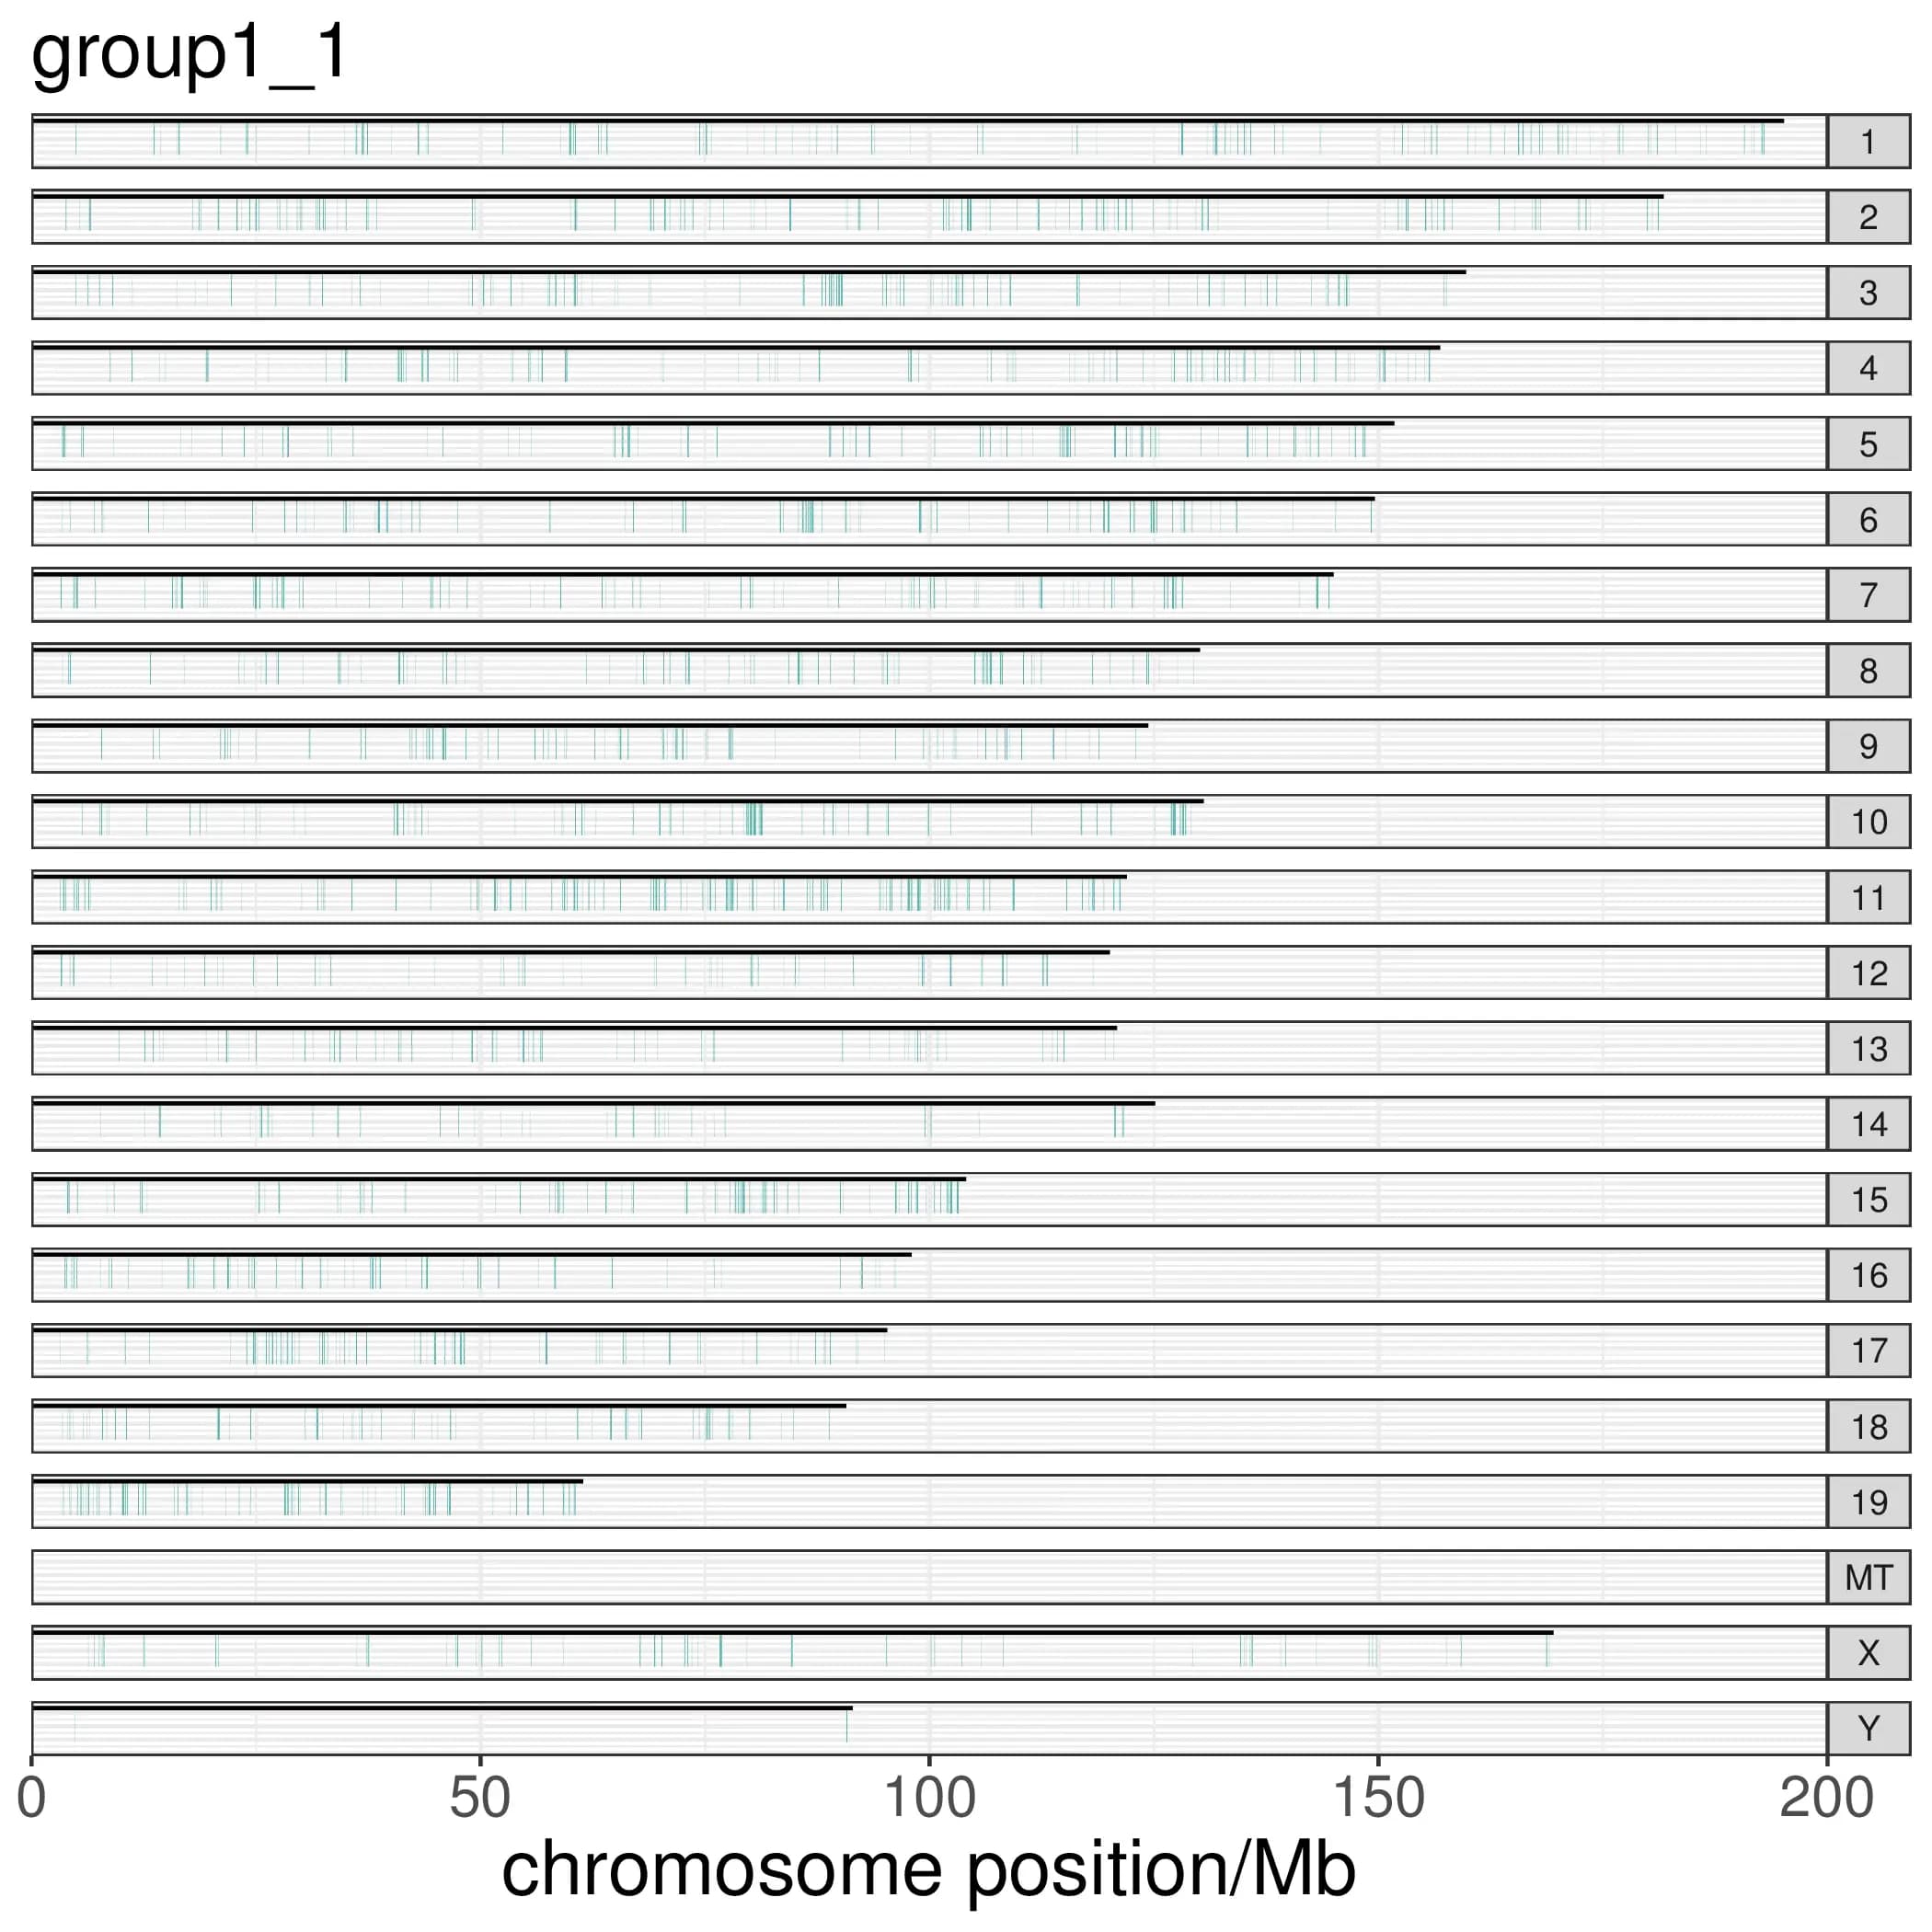
ピークのゲノムワイド分布

ピークのゲノムワイド分布の概要を以下の図に示します。染色体にマッピングされたピーク数とその分布から、タンパク質結合部位の分布を把握できます。

横軸は染色体上のピークの位置、縦軸は染色体を表しています。それぞれの青いバーは、ピークを示しています。

Image
Image
1/1
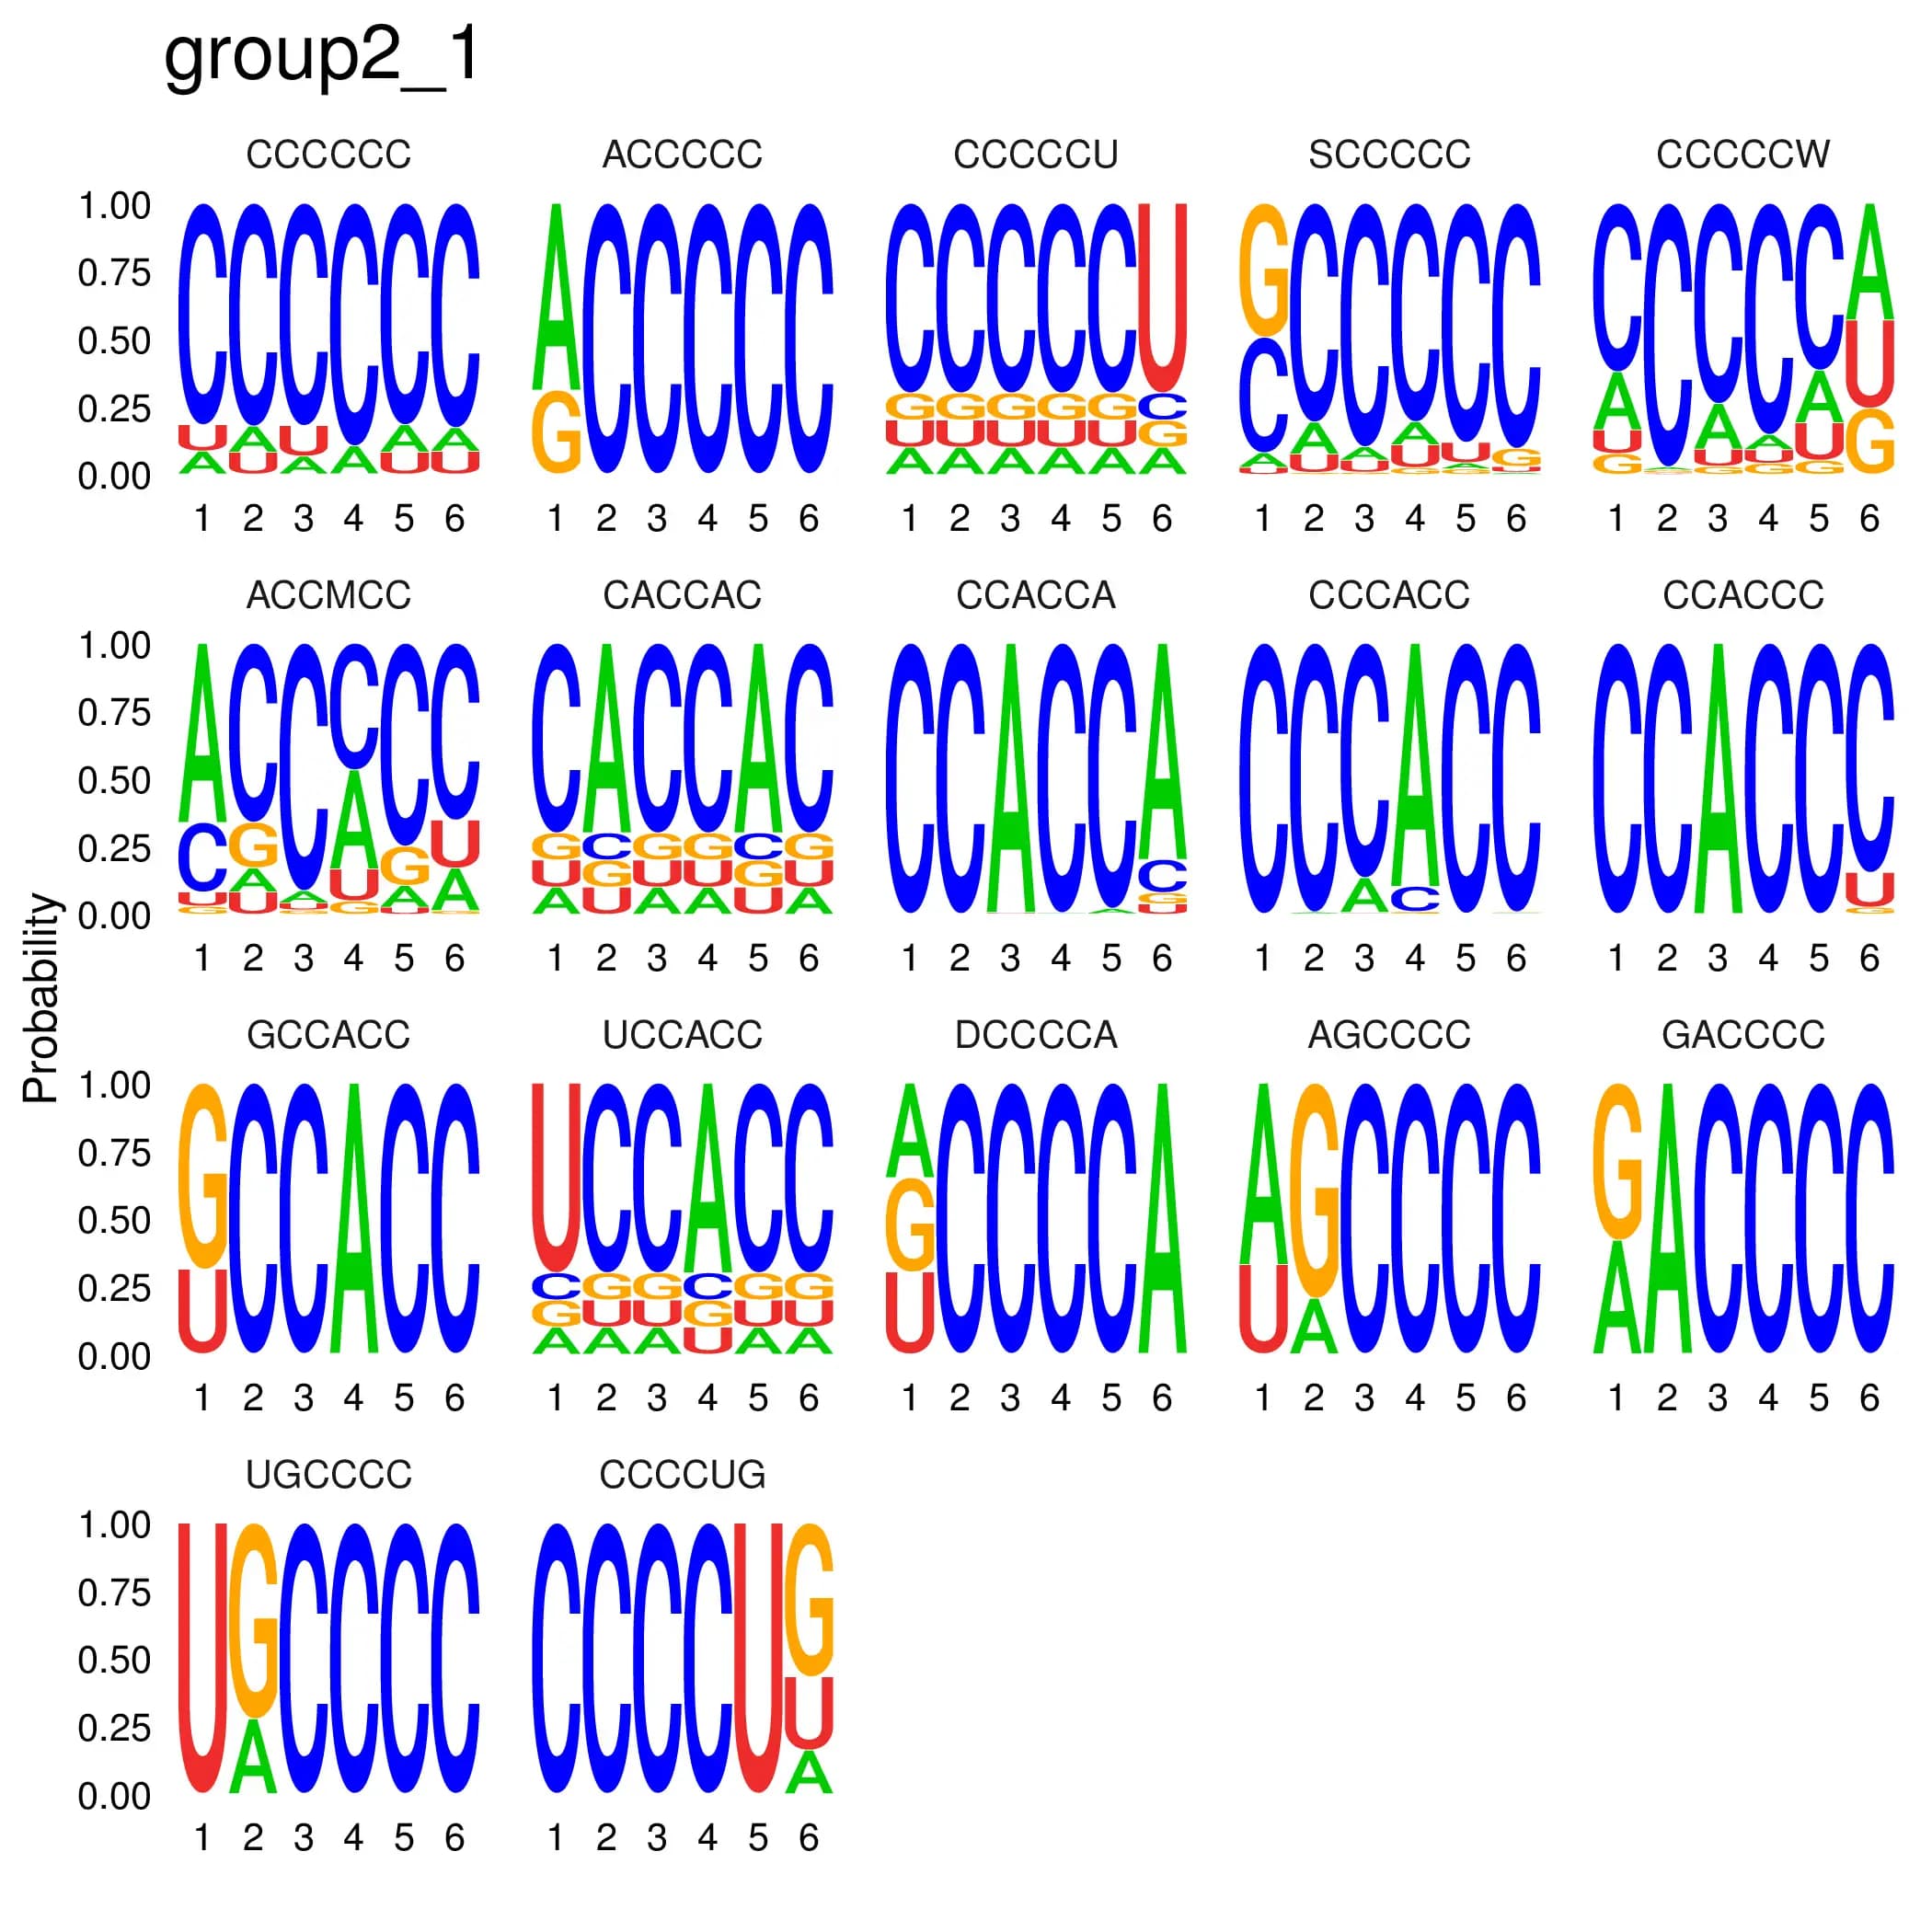
モチーフ解析

モチーフはピーク位置における配列保存性を示し、遺伝子発現制御に関与している可能性があります。以下は、同定されたピーク結合に関連するmRNA領域上のモチーフを表示したものです。

各実験群について、長さ6、8、10、12のモチーフのうち有意性の高い上位25件を同定します。各モチーフの詳細については、結果ファイルおよびreadmeファイルをご参照ください。

Image
Image
1/1
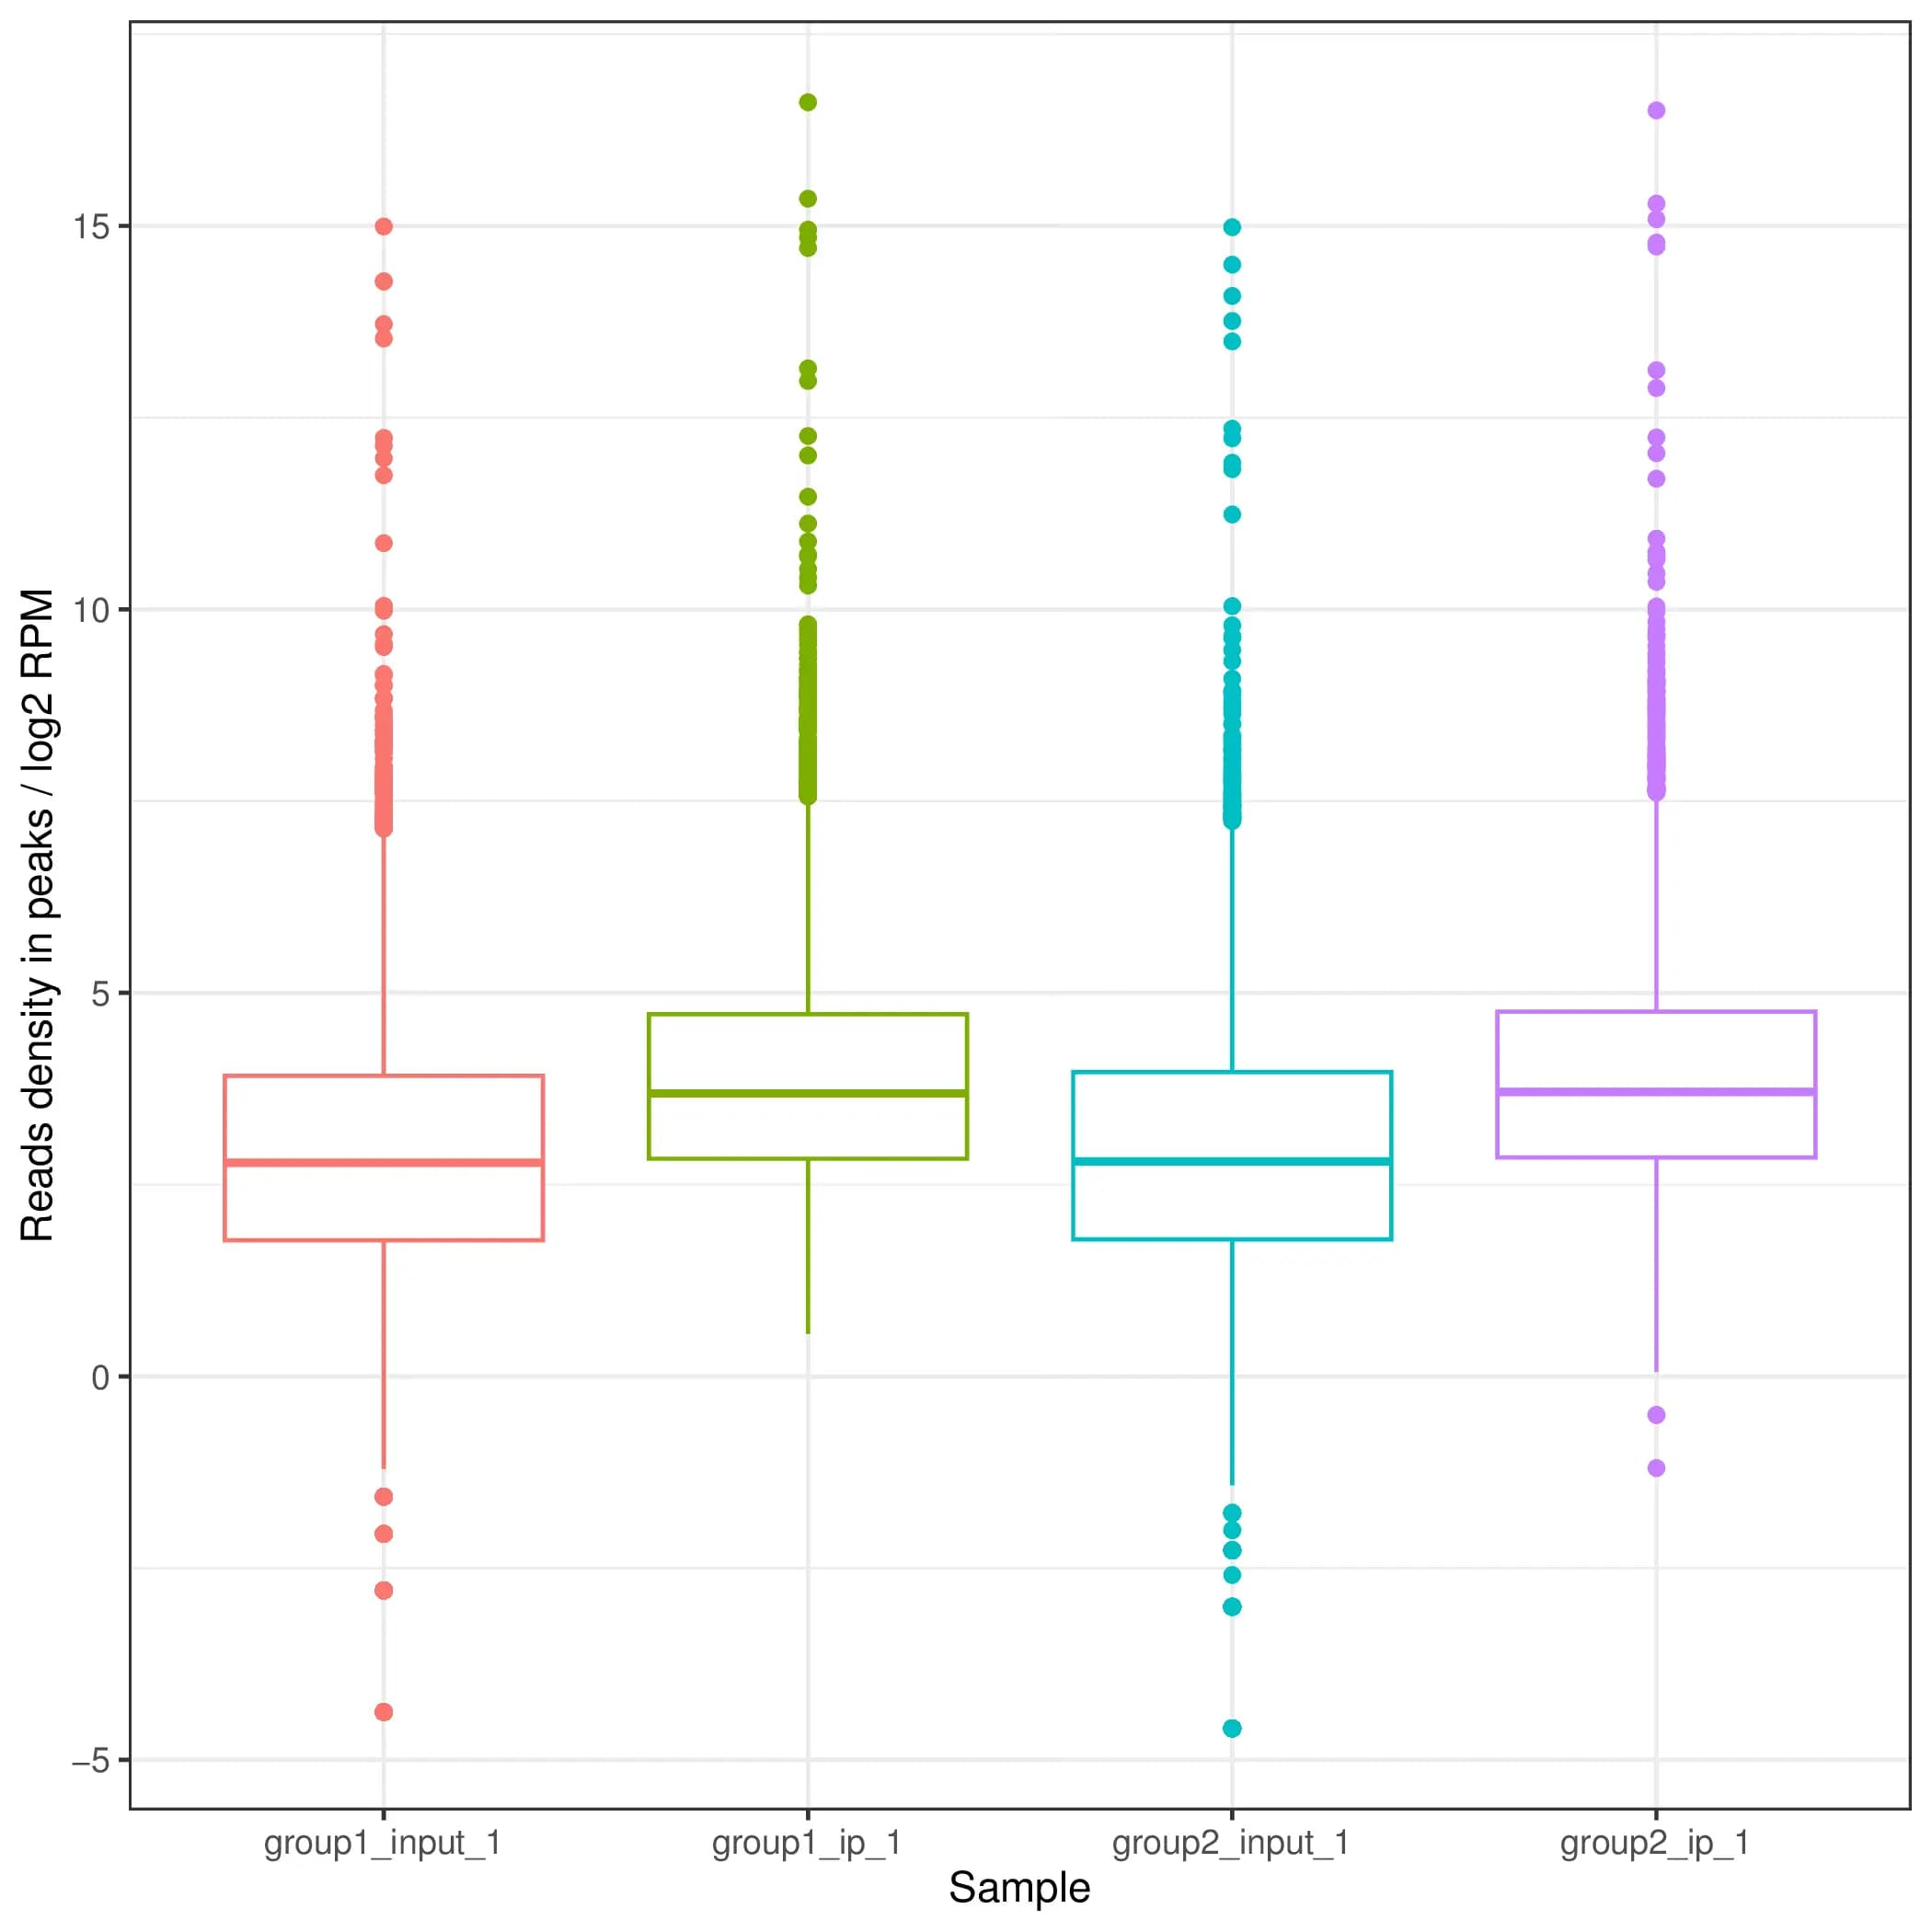
アノテーションされたピークにおける比較群間のリード密度分布

RPMは、100万リード当たりのピーク領域に濃縮されたリード数です。ボックスプロットを用いて、異なるサンプルにおけるアノテーション済みピーク領域のリード濃縮度を示します。

Image
Image
1/1
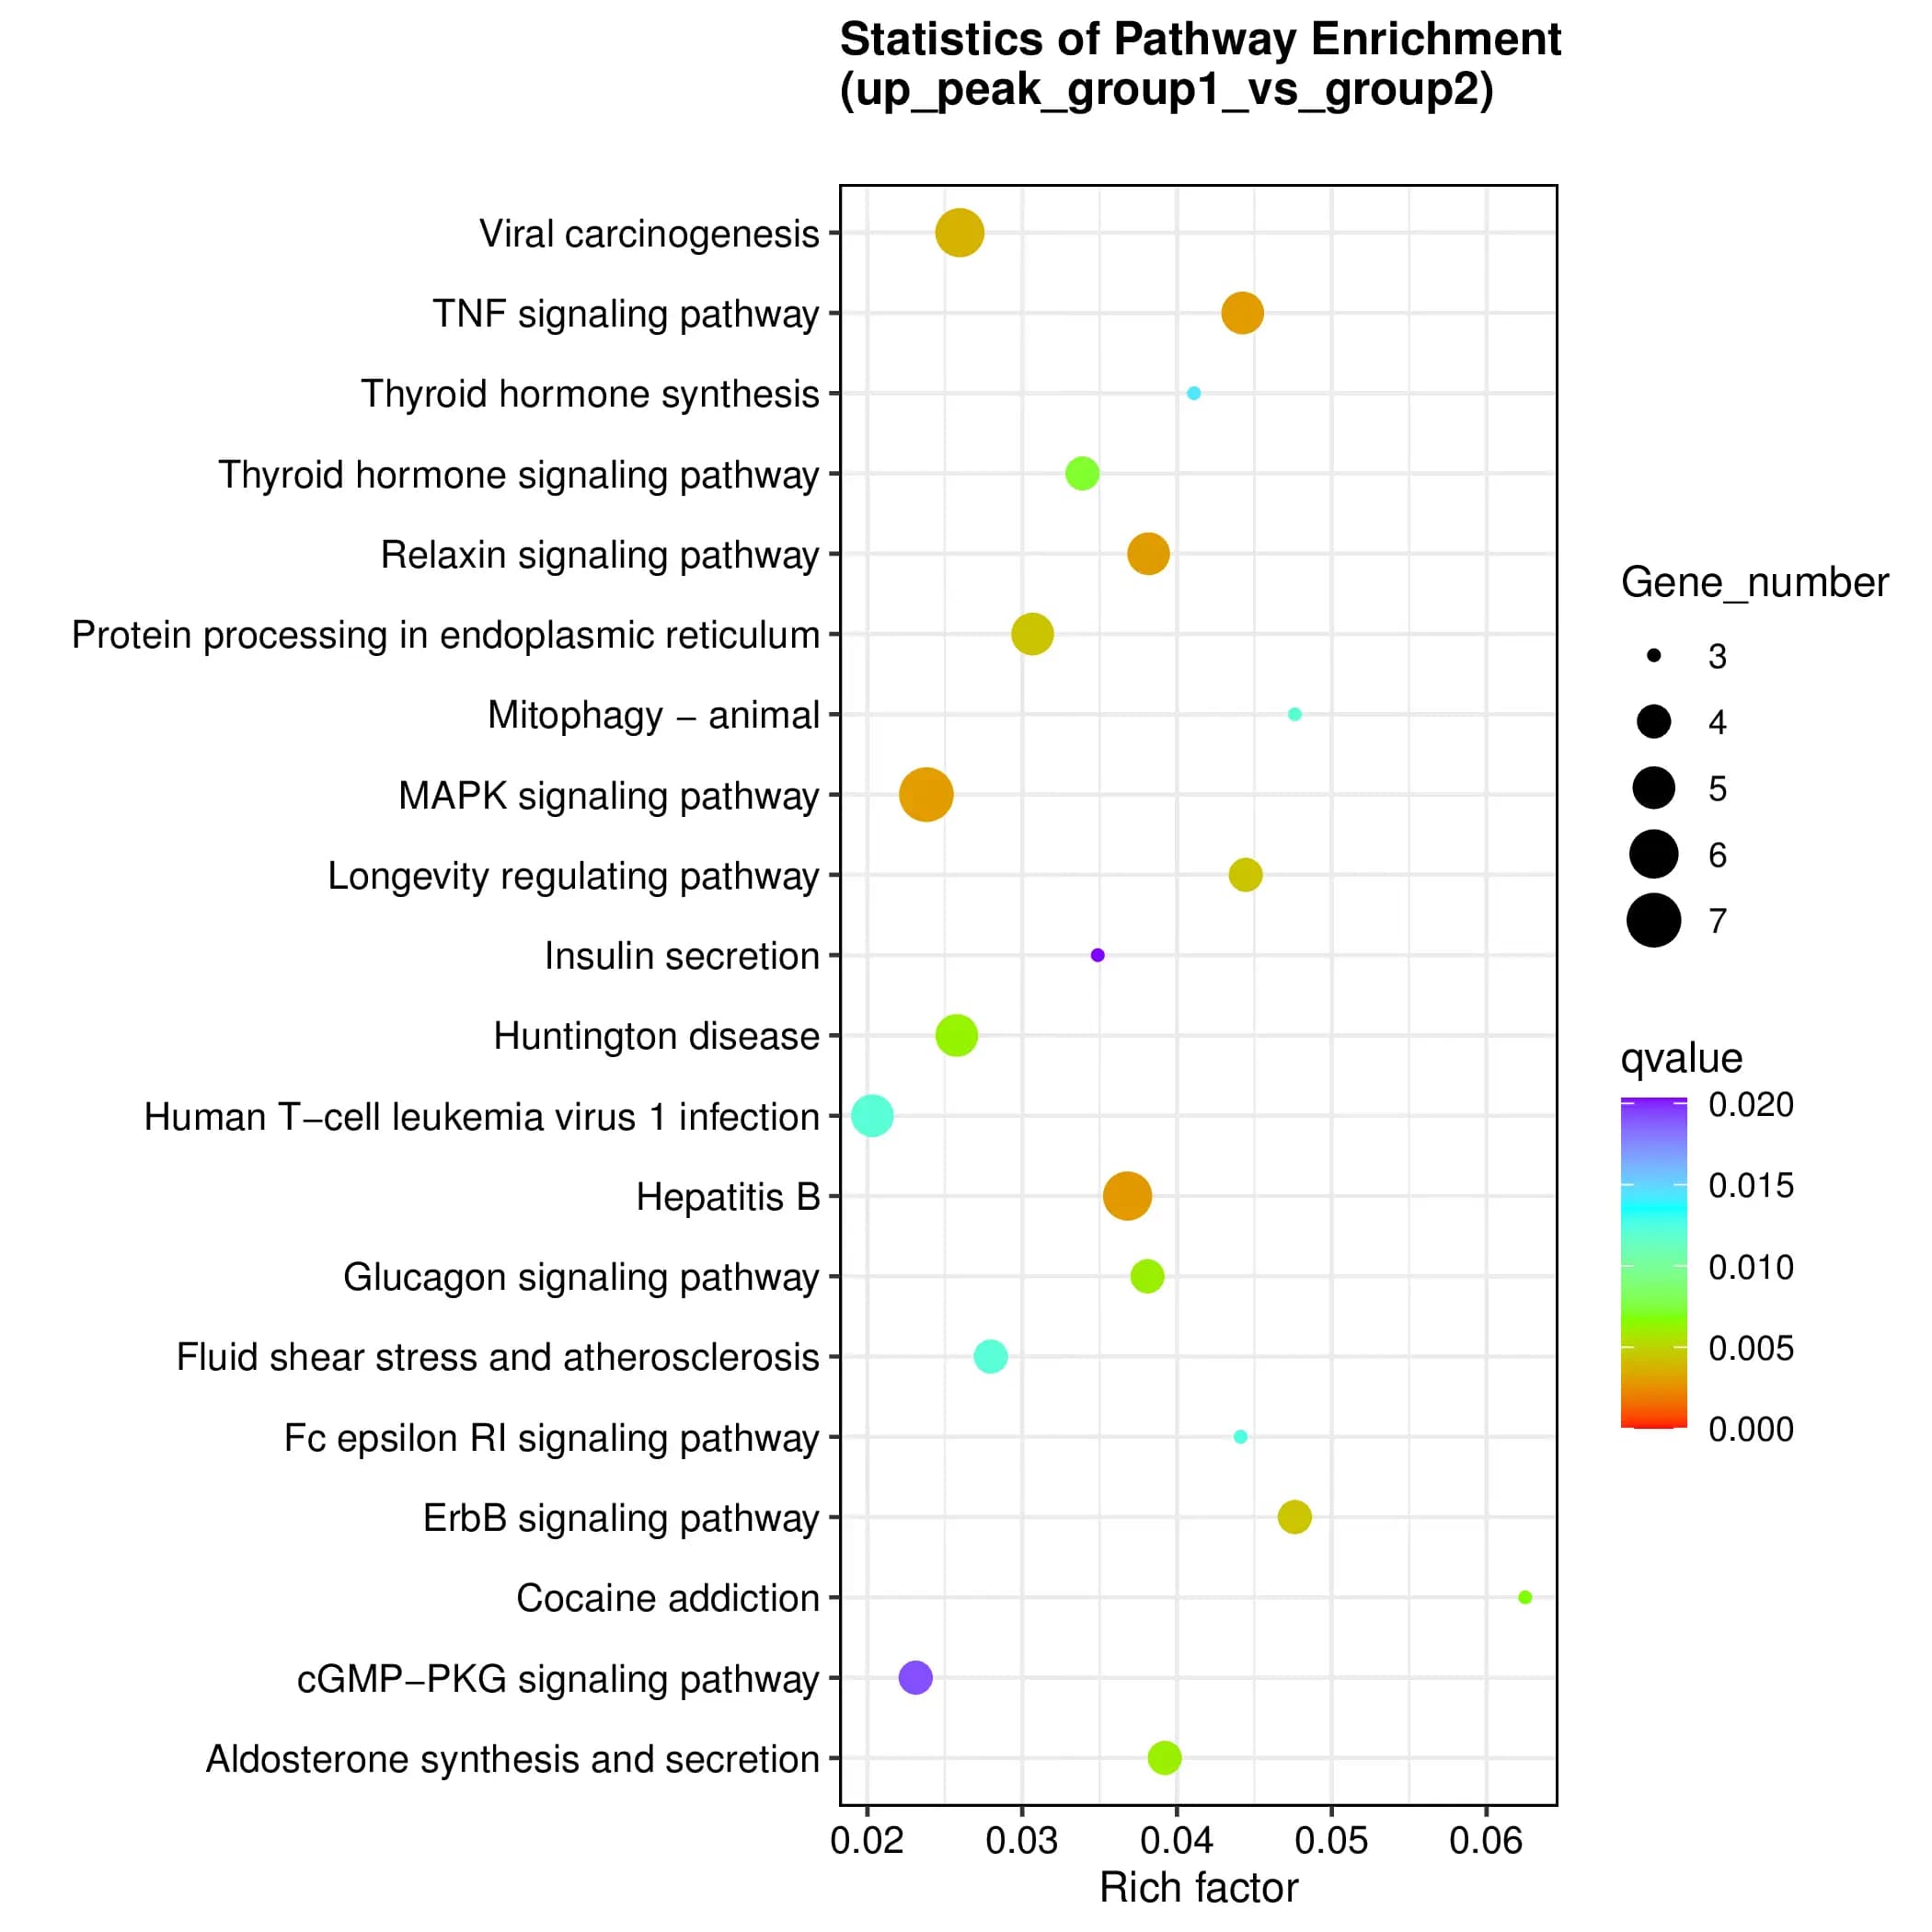
変動ピーク関連遺伝子のKEGGエンリッチメント解析

変動ピーク関連遺伝子に対するKEGGエンリッチメント解析を以下に示します。

Image
Image
1/1
ピークのゲノムワイド分布

ピークのゲノムワイド分布の概要を以下の図に示します。染色体にマッピングされたピーク数とその分布から、タンパク質結合部位の分布を把握できます。

横軸は染色体上のピークの位置、縦軸は染色体を表しています。それぞれの青いバーは、ピークを示しています。

Image
Image
1/1
モチーフ解析

モチーフはピーク位置における配列保存性を示し、遺伝子発現制御に関与している可能性があります。以下は、同定されたピーク結合に関連するmRNA領域上のモチーフを表示したものです。

各実験群について、長さ6、8、10、12のモチーフのうち有意性の高い上位25件を同定します。各モチーフの詳細については、結果ファイルおよびreadmeファイルをご参照ください。

Image
Image
1/1
アノテーションされたピークにおける比較群間のリード密度分布

RPMは、100万リード当たりのピーク領域に濃縮されたリード数です。ボックスプロットを用いて、異なるサンプルにおけるアノテーション済みピーク領域のリード濃縮度を示します。

Image
Image
1/1
変動ピーク関連遺伝子のKEGGエンリッチメント解析

変動ピーク関連遺伝子に対するKEGGエンリッチメント解析を以下に示します。

その他のサービス

全ゲノムバイサルファイトシーケンス(WGBS)
(全ゲノムバイサルファイトシーケンス(WGBS))
全ゲノムバイサルファイトシーケンス(WGBS)
(全ゲノムバイサルファイトシーケンス(WGBS))
クロマチン免疫沈降シーケンス(ChIP-seq)
(クロマチン免疫沈降シーケンス(ChIP-seq))
クロマチン免疫沈降シーケンス(ChIP-seq)
(クロマチン免疫沈降シーケンス(ChIP-seq))
トータルRNAシーケンス
(トータルRNAシーケンス)
トータルRNAシーケンス
(トータルRNAシーケンス)
Illuminaシーケンサーによるシーケンスのみのサービス
(Illuminaシーケンサーによるシーケンスのみのサービス)
Illuminaシーケンサーによるシーケンスのみのサービス
(Illuminaシーケンサーによるシーケンスのみのサービス)
Background
Background

プロジェクトを開始する準備はできていますか?

当社のプラットフォームは、

プロジェクト設計からデータ納品まで、お客様固有の実験ニーズに合わせたソリューションを提供し、シームレスな体験を実現します。


プライバシーポリシーCookieポリシーキャリア