ノボジーン
  • ノボジーン
  • ゲノミクス
    • ヒト全ゲノムシーケンス
    • 動植物全ゲノムシーケンス
    • 微生物全ゲノムシーケンス
    • 動植物de novoシーケンス
    • 微生物de novoシーケンス
    • ショットガンメタゲノムシーケンス
    • アンプリコンシーケンス
    • 全エクソームシーケンス
    トランスクリプトミクス
    • mRNAシーケンス
    • トータルRNAシーケンス
    • 全長トランスクリプトームシーケンス
    • 全トランスクリプトームシーケンス
    • スモールRNAシーケンシング
    • 環状RNAシーケンス
    • メタトランスクリプトームシーケンス
    • 原核生物RNAシーケンス
    シングルセルと空間オミクス
    • シングルセル遺伝子発現解析
    • シングルセル免疫プロファイリングシーケンス
    • シングルセルロングリードトランスクリプトーム
    エピゲノミクス
    • 全ゲノムバイサルファイトシーケンス(WGBS)
    • ディレクトDNAメチレーションシーケンス(DM-Seq)new
    • 還元型バイサルファイトシーケンス (RRBS)
    • クロマチン免疫沈降シーケンス(ChIP-Seq)
    • RNA免疫沈降シーケンス (RIP-Seq)

    相乗りシーケンス

    • 相乗りシーケンス(イルミナプラットフォーム)
    • 相乗りシーケンス(PacBioプラットフォーム)
    プロテオミクス & メタボロミクス
    • Olinkプロテオミクス
  • プロモーションプロモーション
    • プラットフォーム
    • インテリジェント自動化プラットフォーム(Falcon)
    • バイオインフォマティクス解析ツール(NovoMagic)
    • カスタマサービスシステム(CSS)
    • パンフレット
    • ケーススタディ
    • ウェビナー
    • ブログ
    • サンプルガイドライン
    • コンミュニティ
    • がん研究
    • がん免疫
    • アグリゲノミクス
    • 環境
    • 食品科学
    • ヒトマイクロバイオーム
    • 植物および動物マイクロバイオーム
    • 創薬および開発
    • 希少および複雑性疾患
    • ノボジーンについて
    • 拠点一覧
    • ニュース
    • キャリア
  • お問い合わせお問い合わせ
  1. Home
  2. Company
  3. ノボジーンのNovaSeq X Plusデータ一覧!最大465Gb/レーン、平均Q30 >95%に到達

ノボジーンのNovaSeq X Plusデータ一覧!最大465Gb/レーン、平均Q30 >95%に到達

NovaSeq X Plusは、イルミナの最新ハイスル プットシ ケンスシステムで、スル プット、シ ケンス能力、サステナビリティの面において卓越した性能を発揮します。従来のシ ケンサ と比較して最大2.5倍のスル プットで、年間20,000以上のヒト全ゲノムデータを生成でき、大規模なシ ケンスプロジェクトや挑戦的なゲノミクス研究に最適な選択肢を提供します。PhiXライブラリおよびヒト全ゲノムシ ケンスでの評価が完了しました。結果を現在公開いたします。最先端ソリュ ションの驚くべき能力をご覧ください。

1. PhiXライブラリを用いた評価テストのQC概要

平均データ出力とQ30は、それぞれ443Gb/レーン、95%以上です。あるレーンでは、465Gbに達しました。

表1. 各レーンのリ ド1のQC結果

Lane No.PF (%)Reads PF (M)Q30 (%)Yield (GB)Error Rate (%)
175.26 ± 8.351,468.0895.17217.050.51 ± 0.4
278.59 ± 3.171,533.0295.49227.590.33 ± 0.3
376.73 ± 4.691,496.7495.25221.740.55 ± 0.57
475.88 ± 11.661,480.0395.67218.620.51 ± 0.58
577.85 ± 12.491,518.4396.17223.850.45 ± 0.35
680.67 ± 4.641,573.5296.31232.690.38 ± 0.28
775.64 ± 13.111,475.4895.71218.130.44 ± 0.33
873.38 ± 12.551,431.2995.66211.120.43 ± 0.3

表2. 各レーンのリ ド2のQC結果

Lane No.PF (%)Reads PF (M)Q30 (%)Yield (GB)Error Rate (%)
175.26 ± 8.351,468.0894.95217.130.42 ± 0.38
278.59 ± 3.171,533.0295.1227.220.38 ± 0.31
376.73 ± 4.691,496.7495.21221.80.47 ± 0.35
475.88 ± 11.661,480.0395.44218.530.46 ± 0.41
577.85 ± 12.491,518.4395.57223.840.53 ± 0.38
680.67 ± 4.641,573.5295.68232.510.45 ± 0.4
775.64 ± 13.111,475.4895.33218.170.48 ± 0.42
873.38 ± 12.551,431.2995.07210.960.51 ± 0.4

2. ヒト全ゲノムシ ケンスの評価結果

ライブラリ調製用にサンプルNA12878を用い、NovaSeq X PlusとNovaSeq 6000で同時に全ゲノムシ ケンスを行い、プラットフォ ム性能をさらに評価しました。

2.1 QC

NovaSeq 6000と比較して、NovaSeq X Plusプラットフォ ムはQ30において優れた性能を発揮しました(平均94.63%)。

表3. サンプルNA12878のQC

SampleEffective (%)Error (%)Q20 (%)Q30 (%)GC (%)Containing N (%)Low quality (%)Adapter related (%)
NA12878_NovaSeq X Plus_199.830.0396.9194.4541.720.010.000.16
NA12878_NovaSeq X Plus_299.880.0396.8194.6741.140.000.000.12
NA12878_NovaSeq X Plus_399.870.0396.7794.4141.30.000.000.13
NA12878_NovaSeq X Plus_499.820.0397.3194.9741.730.010.000.17
NA12878_NovaSeq 600099.830.0397.6093.3442.080.000.000.17

2.2 マッピング統計値

NovaSeq X PlusおよびNovaSeq 6000プラットフォ ムは、平均シ ケンスデプス30xの下で〜99%のカバレッジで全ゲノムにわたって均一なカバレッジを達成しました。

表4. サンプルNA12878のマッピング統計値

SampleMapped (%)Properly (%)PE mapped (%)Average Sequencing Depth (%)Coverage (%)4X (%)10X (%)20X (%)
NA12878_NovaSeq X Plus_199.7597.0699.7029.9998.9998.6497.8488.41
NA12878_NovaSeq X Plus_299.7497.0999.6930.0198.9998.6497.8188.92
NA12878_NovaSeq X Plus_399.7197.0299.6629.9698.9998.6497.8388.86
NA12878_NovaSeq X Plus_499.7197.0499.6729.9698.9998.6397.8388.52
NA12878_NovaSeq 600099.8996.9099.8328.8498.6398.6397.7785.19

2.3 バリアントコ ル精度

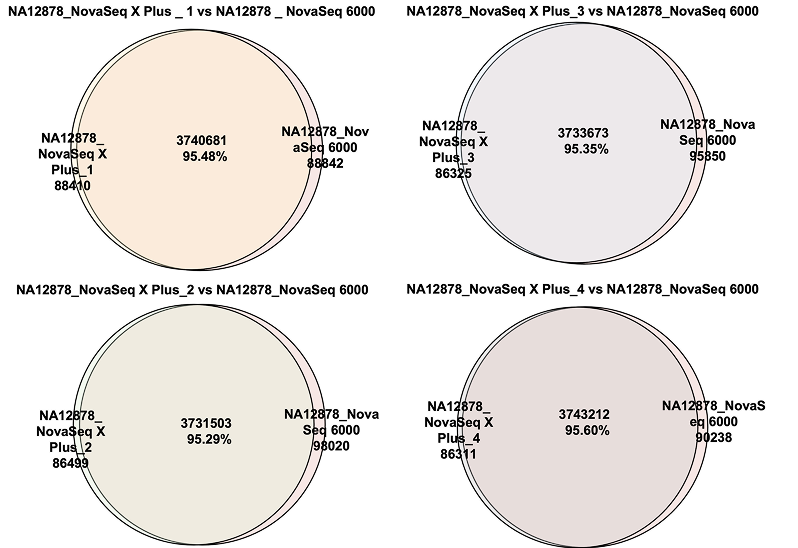
NovaSeq X PlusとNovaSeq 6000は、SNP検出において95%以上の一致率があります。2つのプラットフォ ム間のSNPとInDelの精度およびリゴール偏差は<0.2%です。

表5. サンプルNA12878のバリアントコ ル結果

SamplePrecision (SNP) (%)Recall (SNP) (%)F-score (SNP) (%)Precision (InDel) (%)Recall (InDel) (%)F-score (InDel) (%)dbSNP (SNP) (%)dbSNP (InDel) (%)
NA12878_NovaSeq X Plus_199.1897.9498.5588.0985.9286.9996.5588.34
NA12878_NovaSeq X Plus_299.1497.8498.4887.9385.9586.9396.5588.50
NA12878_NovaSeq X Plus_399.1497.8698.5087.9886.0987.0296.5788.46
NA12878_NovaSeq X Plus_499.1697.9898.5788.0786.1887.1296.5188.30
NA12878_NovaSeq 600099.3698.0198.6888.5986.0487.3096.6688.41

図1. NovaSeq X PlusとNovaSeq 6000の間で共有されるSNPのベン図

NovaSeq X PlusとNovaSeq 6000プラットフォームでは、別々のレーンでシーケンスされたサンプル間で高いデータの一致が観察されました。これは、シーケンスラン間でのバリアント検出の高い再現性と、最新のシーケンスプラットフォームで当社のワークフローによって達成可能な高品質なデータを実証しています。

ノボジーンについて

ノボジーンは、最先端の分子生物学技術とハイパフォーマンスコンピューティングを、ライフサイエンスとヒューマンヘルスの分野の研究に応用するパイオニアです。そのビジョンは、ゲノミクスサービスとソリューションの提供において、グローバルリーダーであり続けることです。

世界最大級のシーケンスキャパシティを擁し、深い科学的知識、一流のカスタマーサービス、卓越したデータ品質を駆使して、急速に進化するゲノミクスの世界でお客様の研究目標を実現するお手伝いをします。ノボジーンは、お客様の信頼できるゲノミクスパートナーとなることをお約束します。

用語の説明

(1) Effective(エフェクティブ): 全生成リードのうち、クリーンリードの割合。 (2) Error:エラー: read1とread2の全塩基の平均エラー率。塩基のエラー率は式1より求められる。 (3) Q20: phred-scaled quality scoreが20より大きい塩基の割合。 (4) Q30:Fred Scaleにて計算された品質スコアが30を超える塩基の割合。 (5) GC (%): 全塩基に含まれるGとCの割合。 (6)Containing N(%):どちらか一方のリードで、塩基が不確かなものが10%以上あるリードペア。 (7) Low Quality:どちらか一方のリードにおいて、低品質塩基の割合が50%以上であるリードペア。 (8) Adapter Related: どちらかのリードにアダプターの混入があるリードペア。 (9) Mapped (%): 参照ゲノムにマッピングされたリードの数(割合)。 (10) Properly: 適切にマッピングされたリードの数: 参照ゲノムにマッピングされたリードのうち、予想されるインサートサイズ内にあるリードの数(%)。 (11) PE mapped: 参照ゲノムにマッピングされたペアエンドリードの数(%)。 (12) Coverage: 全ゲノムにおけるカバレッジ。 (13) 4X: 4Xを超えるシーケンス深度の塩基のみを考慮した場合の全ゲノムにおけるカバー率。 (14) 10X (%):シーケンス深度10倍以上の塩基のみを考慮した場合の全ゲノムのカバー率。 (15) 20X (%):シーケンス深度20倍以上の塩基のみを考慮した場合の全ゲノムのカバー率。 (16) Precision=TP/(TP+FP) (パーセント) (17) Recall=TP/(TP+FN)(パーセント) (18) F score=2* Precision*Recall/(Precision + Recall) (19) dbSNP(SNP).dbSNPデータベースで報告されたSNPの数をSNPの総数で割ったものです。 (20) dbSNP (InDel): dbSNPデータベースで報告されているInDelの数をInDelの総数で割った値。 (21) Unique_map: 参照ゲノムのユニークポジションにアライメントされたリードの数と割合(その後の定量データ解析用)、ユニークマッピング率:(ユニークマップリード)/(トータルリード)*100。 (22) Multi_map:参照ゲノムの複数の位置にアライメントされたリードの数と割合、多重マッピング率:(多重マッピングリード)/(全リード)*100。 (23) Error_rate:平均シーケンスエラー率、Qphred=-10log10(e)で算出される。 (24) Exon:エクソン: ゲノムのエクソン領域にアライメントされたリードの数、およびクリーンリードに占める割合。 (25) Exon map: ゲノムのエクソン領域にアライメントされた塩基の数と、ゲノムにアライメントされた塩基数に対する割合です。

サービスサービス menu

サポートサポート menu

会社会社 menu

サービス
全ゲノムシーケンスde novoシーケンスアンプリコンシーケンスショットガンメタゲノムシーケンスディレクトDNAメチレーションシーケンス(DM-Seq)mRNAシーケンスシングルセル遺伝子発現解析Olinkプロテオミクス
サポート
バイオインフォマティクス解析ツール(NovoMagic)カスタマサービスシステム(CSS)インテリジェント自動化プラットフォーム(Falcon)
会社
ノボジーンについて拠点一覧プラットフォームニュースキャリアお問い合わせ
YouTubeYouTube hoverXX hover
Copyright © 2026 Novogene Inc. All rights reserved. 本サービスは研究目的のみにご利用ください。臨床診断目的には使用頂けません。
プライバシーポリシーCookieポリシーキャリア